CASE STUDY
Optical Context MCP
Dasselbe PDF, bis zu 85 % weniger Kontext: Ein veröffentlichtes MCP-Paket packt OCR-lastige Seiten zu wenigen Bildpaketen für Vision-LLMs – Layout, Tabellen und Zeichnungen bleiben erhalten, und ein Modell bestimmt die Packdichte selbst.
- Rolle
- Konzeption, Entwicklung und Veröffentlichung
- Status
- Open Source auf PyPI, 5 Releases
AUSGANGSLAGE
Problem
Gescannte und OCR-lastige PDFs sind für Vision-LLMs teuer: Jede Seite belegt als eigenes Bild Kontext, und bei längeren Dokumenten ist das Fenster voll, bevor das Modell überhaupt anfangen kann. Reiner Textextrakt ist keine Lösung, weil bei Layout, Tabellen und Zeichnungen genau das verloren geht, worauf es ankommt.
SO FUNKTIONIERT ES
Lösung & Architektur
Nutzen
Dasselbe Dokument, 15 % des Kontexts
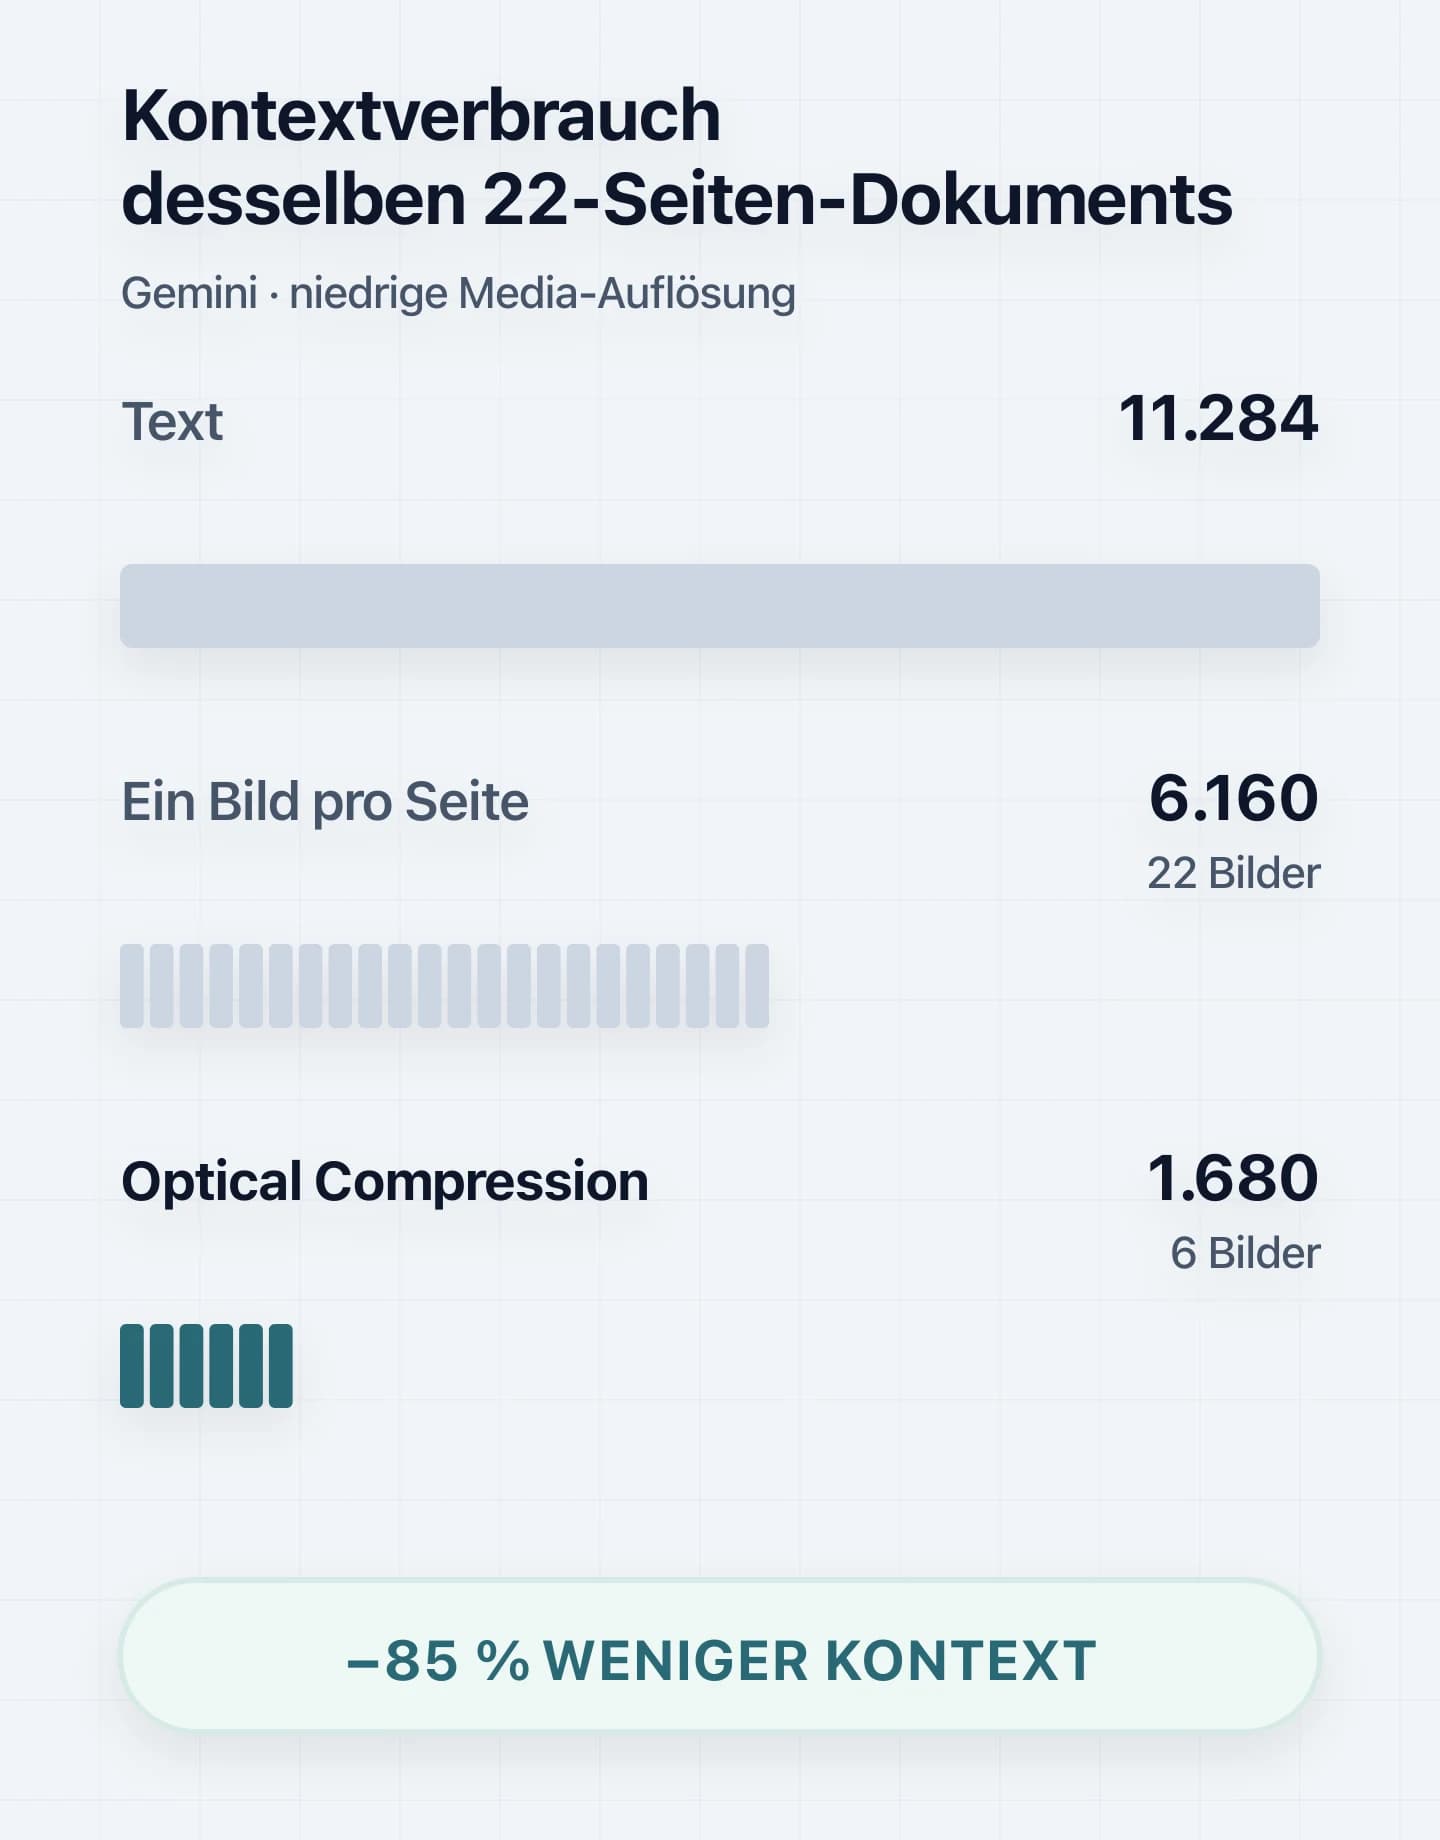
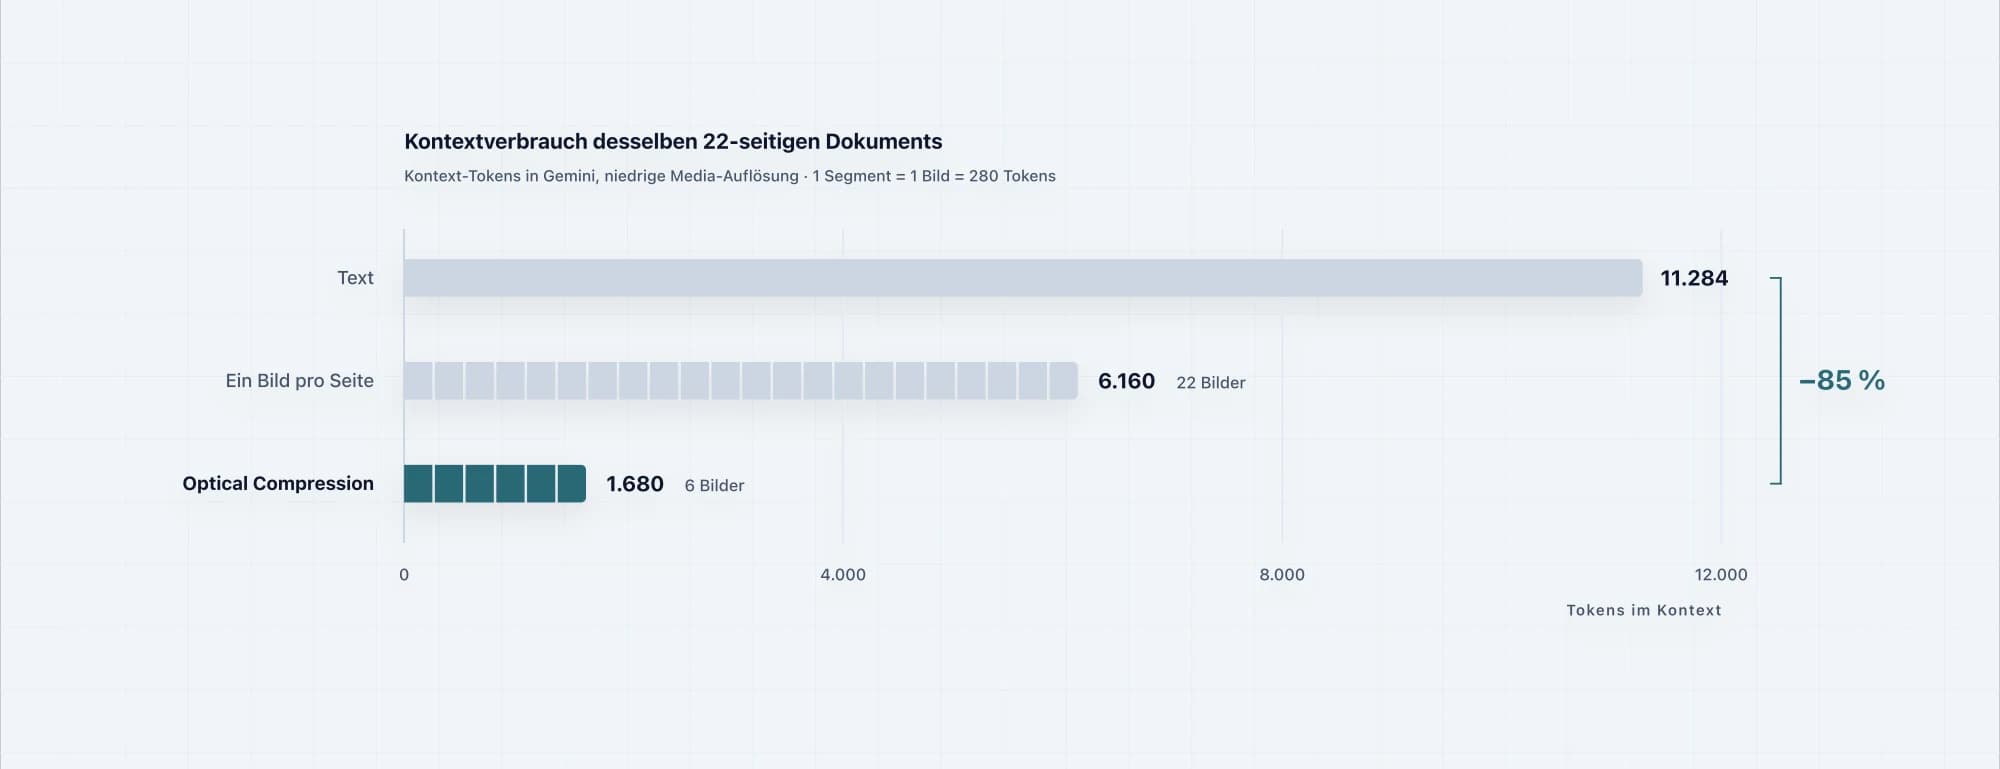
Ein 22-seitiges Paper kostet als Text 11.284 Tokens und als ein Bild pro Seite noch 6.160. Als sechs gepackte Bildpakete sind es 1.680 – das Dokument passt in ein Kontextfenster, in das es vorher nicht passte, kostet pro Anfrage einen Bruchteil und bleibt dabei als Bild lesbar, inklusive Tabellen und Zeichnungen.
- 1.680 statt 11.284 Tokens für dasselbe Dokument
- 6 Bildpakete statt 22 einzelner Seitenbilder
- Layout, Tabellen und Zeichnungen bleiben erhalten
Kompression
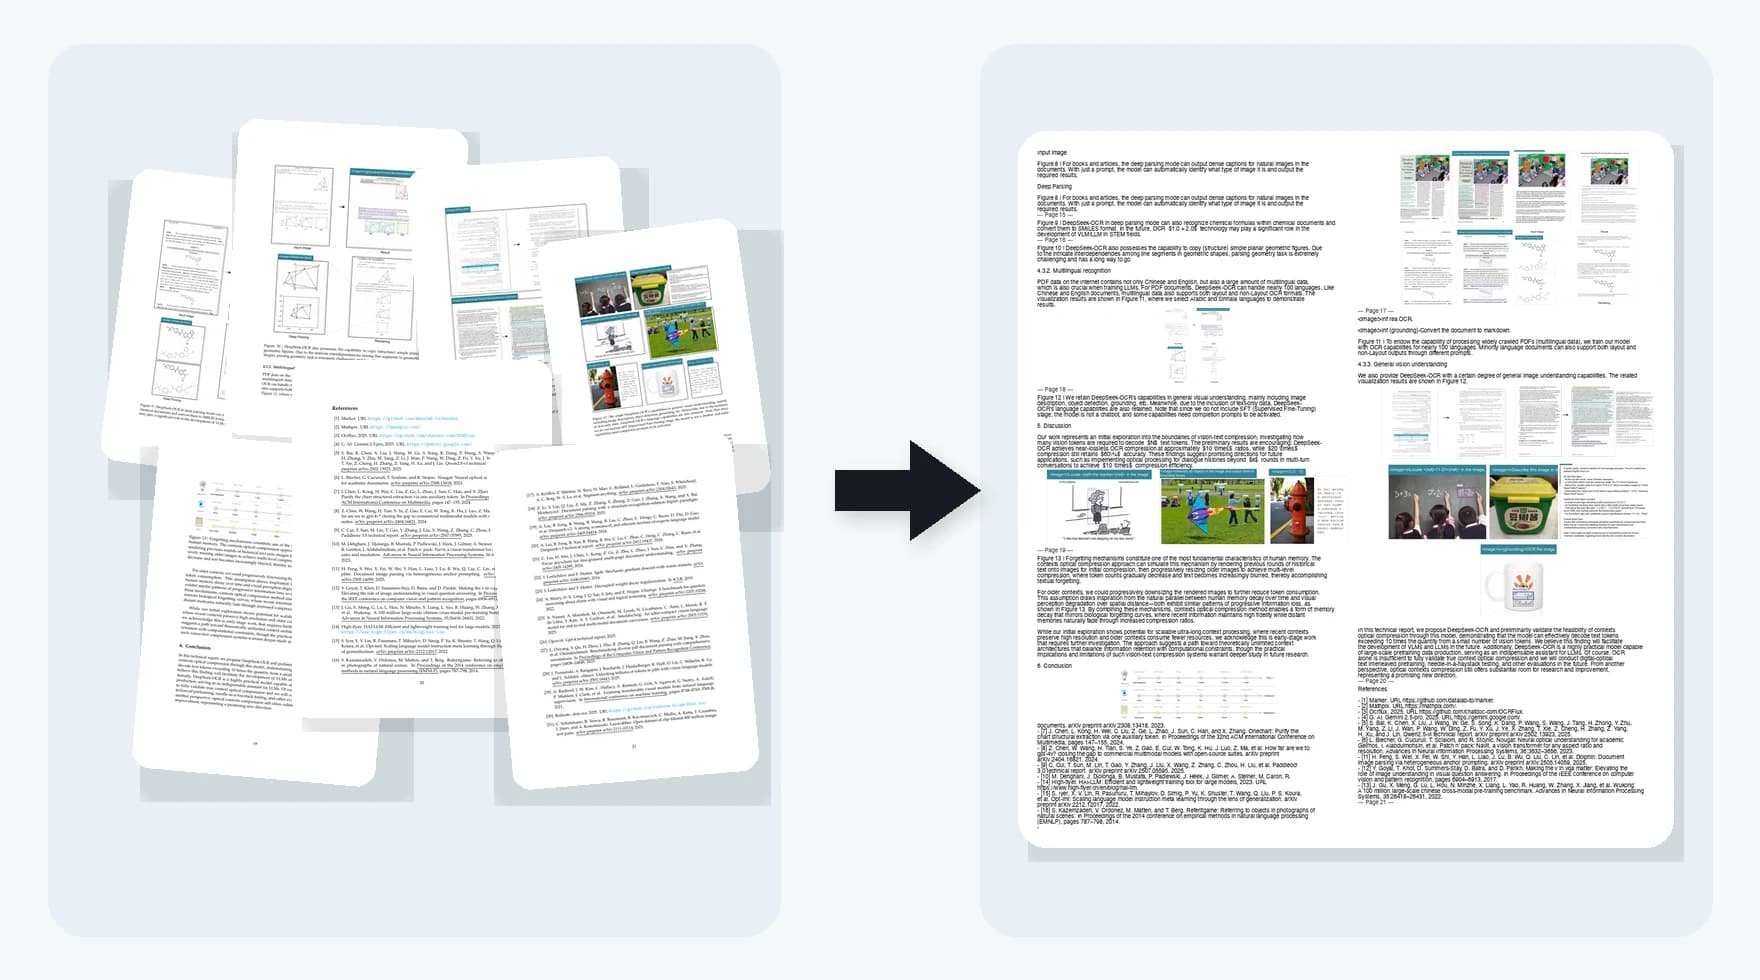
22 Seiten werden zu sechs Bildpaketen
Ein FastMCP-Server mit drei Tools, den jeder MCP-fähige Client einbinden kann, schickt das PDF durch Mistral OCR und packt die Seiten anschließend zu Bildpaketen zusammen, die als Ganzes an ein Vision-LLM gehen.
- 3 Tools für jeden MCP-fähigen Client
- Mistral OCR statt reiner Textextraktion
- bis zu 85 % geschätzte Kontextreduktion bei einem 22-seitigen Testdokument
Modell
Ein Modell entscheidet, wie dicht gepackt wird
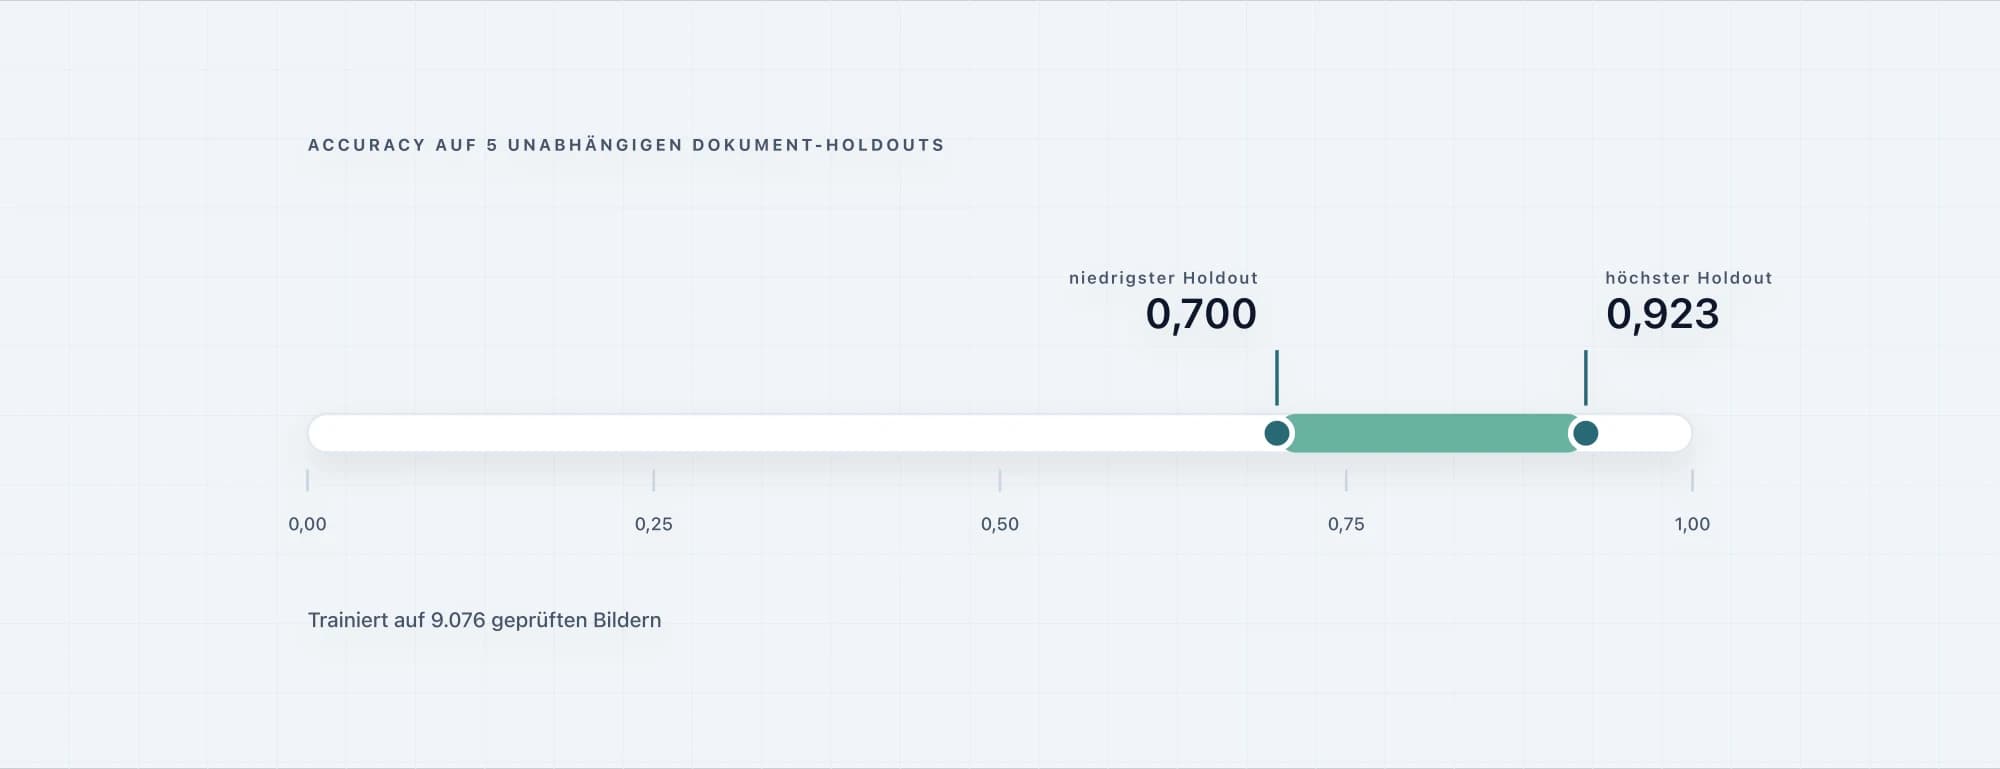
Wie dicht sich Seiten packen lassen, ohne unlesbar zu werden, hängt vom Dokument ab. Das entscheidet deshalb kein fester Schwellwert, sondern ein MobileNetV3, den ich auf 9.076 geprüften Bildern trainiert und auf fünf unabhängigen Dokument-Holdouts evaluiert habe.
- 9.076 geprüfte Trainingsbilder
- Accuracy 0,700–0,923 über 5 Holdouts
- CI mit Trusted Publishing, bisher 5 Releases
Grenzen
Nicht jede Seite lohnt sich als Bild
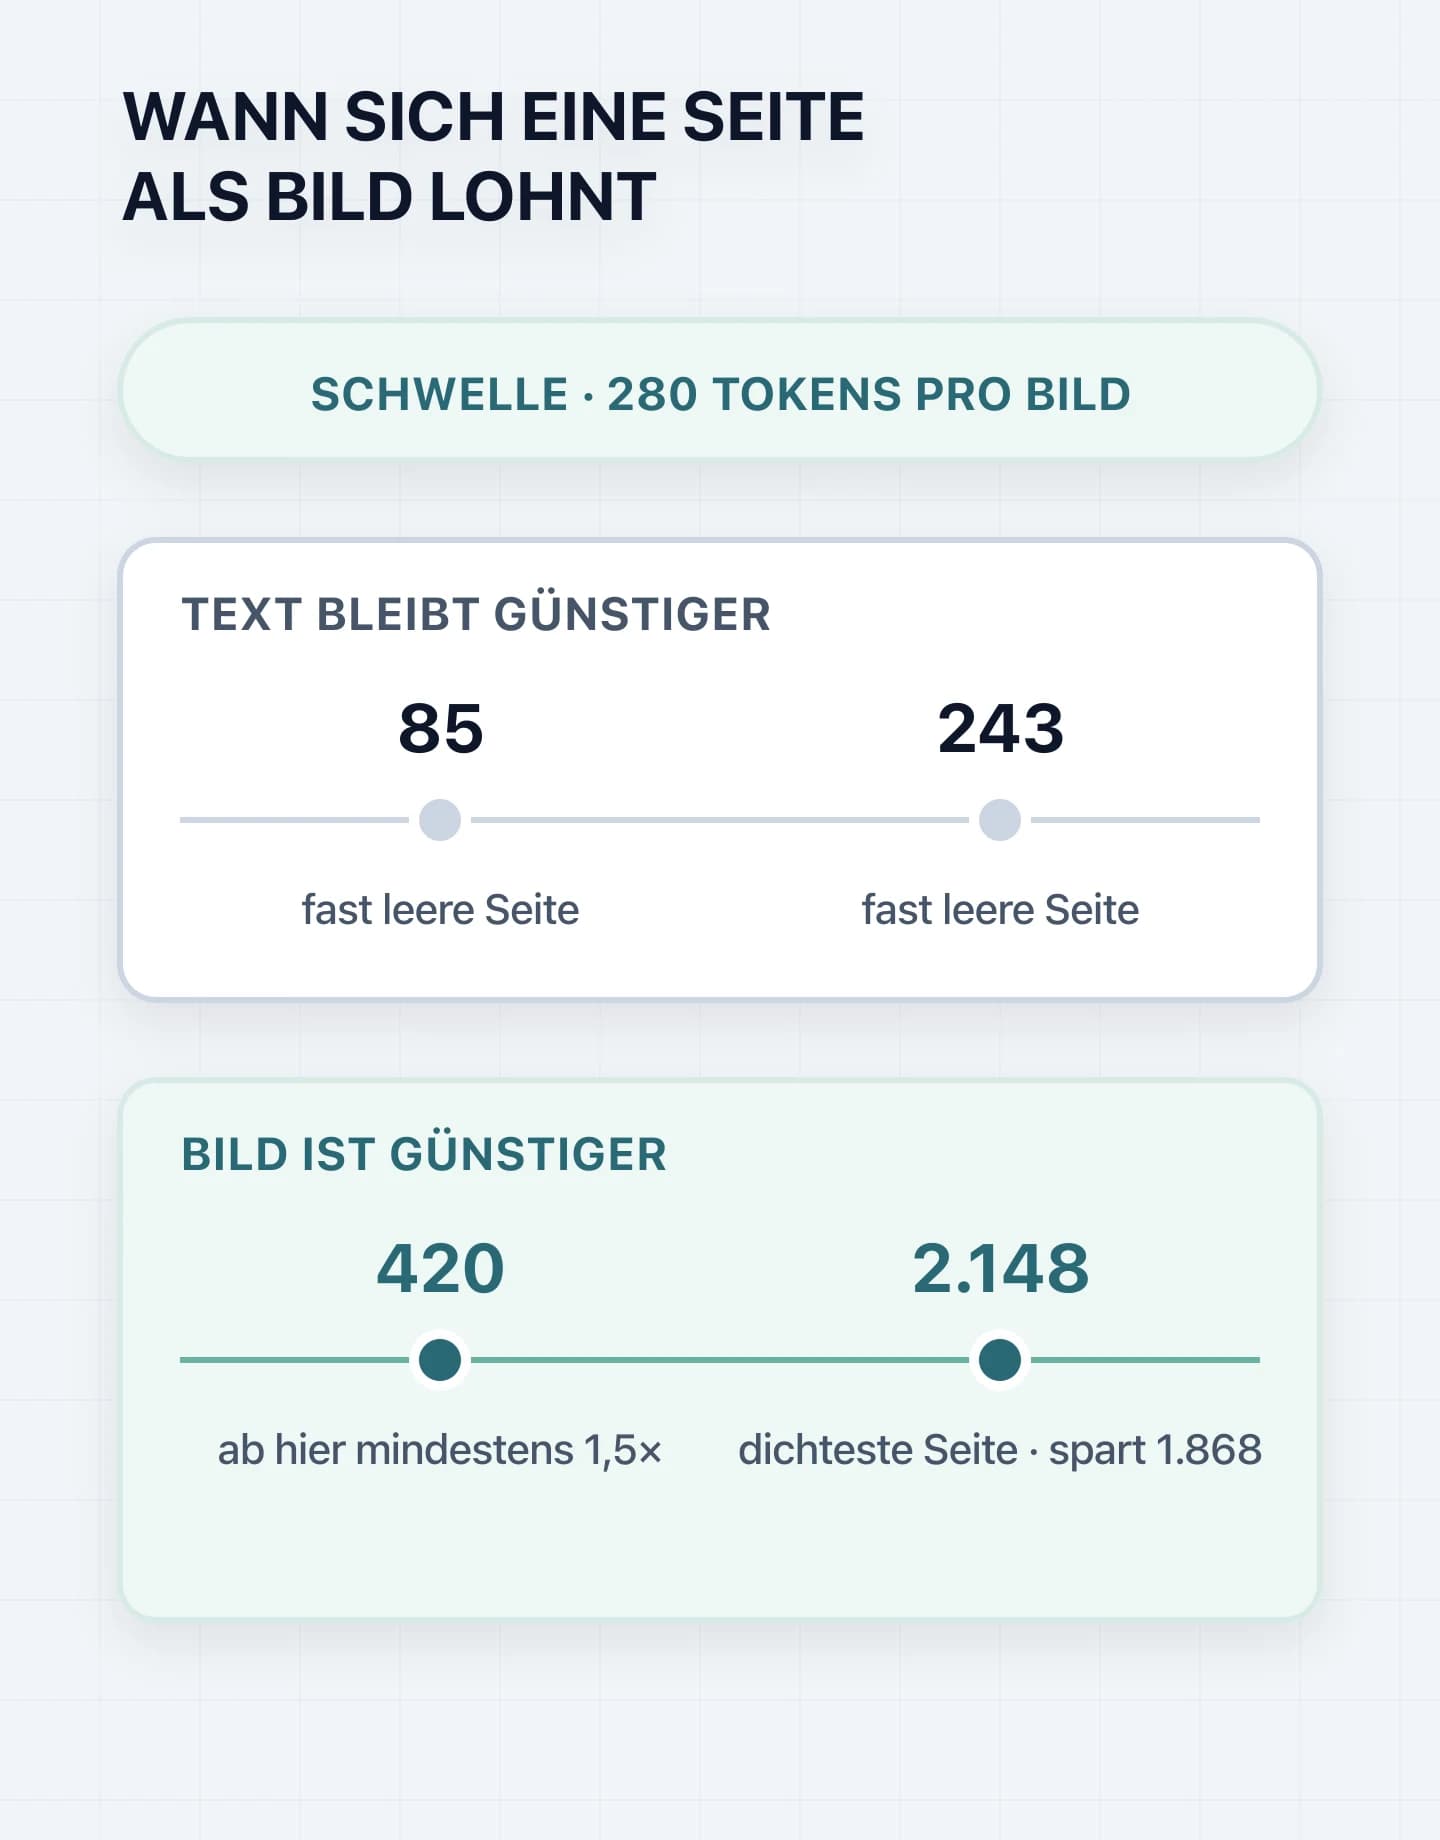
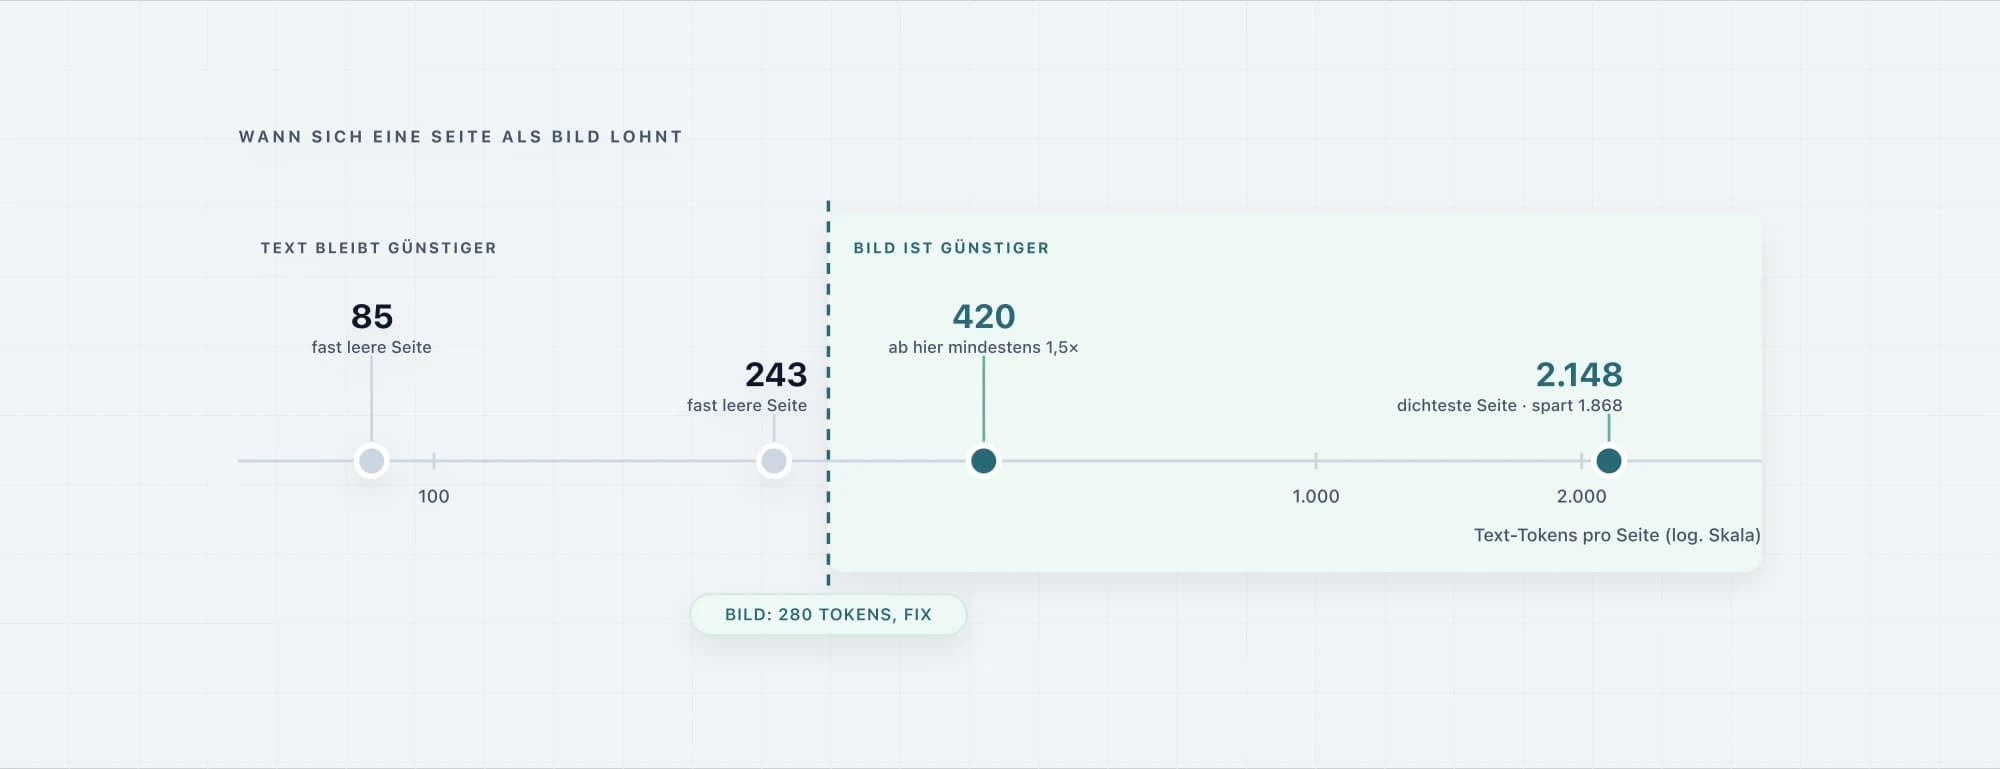
Ein Bild kostet fix 280 Tokens, egal wie viel darauf steht. Eine Seite lohnt sich also erst, wenn ihr Text mehr kostet als das. Im Testdokument lagen 20 von 22 Seiten darüber; die beiden Ausnahmen waren fast leere Seiten am Ende. Die dichteste Seite sparte allein 1.868 Tokens. Der Server rechnet das pro Seite und packt nur, was sich lohnt.
- Break-even bei 280 Text-Tokens pro Seite
- ab etwa 420 Text-Tokens pro Seite lohnt sich das Bild zuverlässig
- gemessen an einem Dokument – kein universeller Wert
ARCHITEKTUR
Der Weg durch das System
gescannt oder OCR-lastig
Mistral OCR
Seitenerkennung
Sizing-Modell
MobileNetV3 bestimmt die Packdichte
Bildpakete
mehrere Seiten pro Bild
Vision-LLM
deutlich weniger Kontext je Dokument
Schnittstelle
FastMCP-Server mit 3 Tools für jeden MCP-Client
Training
9.076 geprüfte Bilder, 5 unabhängige Dokument-Holdouts
Auslieferung: CI mit Trusted Publishing nach PyPI, bislang 5 Releases
Ergebnisse
- weniger Kontext für dasselbe 22-seitige Testdokument
- bis zu 85 %weniger Kontext für dasselbe 22-seitige Testdokument
- Bilder für das 22-seitige Testdokument
- 6 statt 22Bilder für das 22-seitige Testdokument
- geprüfte Trainingsbilder für das Sizing-Modell
- 9.076geprüfte Trainingsbilder für das Sizing-Modell
- Accuracy auf 5 unabhängigen Dokument-Holdouts
- 0,700–0,923Accuracy auf 5 unabhängigen Dokument-Holdouts
NACHWEIS & EINORDNUNG
Was belegt ist – und wo die Aussage endet
Die vier Felder trennen meinen Beitrag, den Projektkontext, die Messgrundlage und die Grenzen der Ergebnisse.
- Mein Anteil
- Konzeption, Entwicklung und Veröffentlichung des FastMCP-Servers, der OCR- und Pack-Pipeline sowie des MobileNetV3-Sizing-Modells. Die Auslieferung erfolgt automatisiert per Trusted Publishing auf PyPI.
- Team & Kontext
- Paket, Quellcode und Forschungs-Repository sind öffentlich verlinkt; fünf Releases dokumentieren die Veröffentlichung. Eine Teamgröße wird in den vorhandenen Projektdaten nicht ausgewiesen und deshalb hier nicht behauptet.
- Messgrundlage
- Das Sizing-Modell wurde auf 9.076 geprüften Bildern trainiert und auf fünf unabhängigen Dokument-Holdouts evaluiert. Die Accuracy liegt je Holdout zwischen 0,700 und 0,923; die Kontextreduktion wurde an einem 22-seitigen Testdokument abgeschätzt.
- Grenzen
- Die Accuracy-Spanne zeigt die Abhängigkeit vom jeweiligen Dokument. Bis zu 85 % Kontextreduktion ist eine Schätzung aus einem 22-seitigen Testdokument und kein universeller Wert für jedes PDF; daraus folgt keine allgemeine Aussage zur Antwortqualität eines Vision-LLMs.
GEBAUT MIT
Tech-Stack
- Python
- FastMCP
- Mistral OCR
- PyTorch
- MobileNetV3
- Pillow
- GitHub Actions
Passt das zu dem, was du vorhast?
Ich baue Systeme, die produktiv laufen sollen statt nur zu demonstrieren. Wenn das zu deinem Vorhaben passt, schreib mir.
Alle Case Studies