Notiz
Optical Context Compression: OCR-lastige PDFs als Bildpakete für Vision-LLMs
Warum Text als Bild günstiger sein kann, wie die Pipeline mit Mistral OCR und einem Sizing-Modell aufgebaut ist und was ein 22-seitiges Testdokument ergibt: bis zu 85 % weniger Kontext.
- Veröffentlicht
- Christopher Böbel, Fullstack AI Engineer
- Christopher Böbel, Fullstack AI Engineer
- 4 Min. Lesezeit
Wer ein Vision-LLM mit einem gescannten PDF füttert, zahlt pro Seite: Jede Seite wird als eigenes Bild in den Kontext gelegt, und bei längeren Dokumenten ist das Fenster voll, bevor das Modell die erste Frage beantworten kann. Reiner Textextrakt ist keine Lösung, weil bei Tabellen, Zeichnungen und Layout genau das verloren geht, worauf es ankommt.
Optical Context Compression ist mein Versuch, beides zu behalten: das Bild und einen bezahlbaren Kontext. Die Idee ist simpel – mehrere Seiten werden zu einem einzigen, dicht gepackten Bild zusammengefasst, und ein kleines Modell entscheidet, wie dicht das gehen darf, ohne dass der Text unlesbar wird.
Das Ergebnis vorweg: Ein 22-seitiges Paper kostet als Text 11.284 Tokens, als ein Bild pro Seite 6.160 – und als sechs gepackte Bildpakete 1.680. Das sind 85 % weniger Kontext für dasselbe Dokument, bei erhaltenem Layout. Ein Dokument, das vorher nicht ins Fenster passte, passt jetzt; jede Anfrage dazu kostet einen Bruchteil.
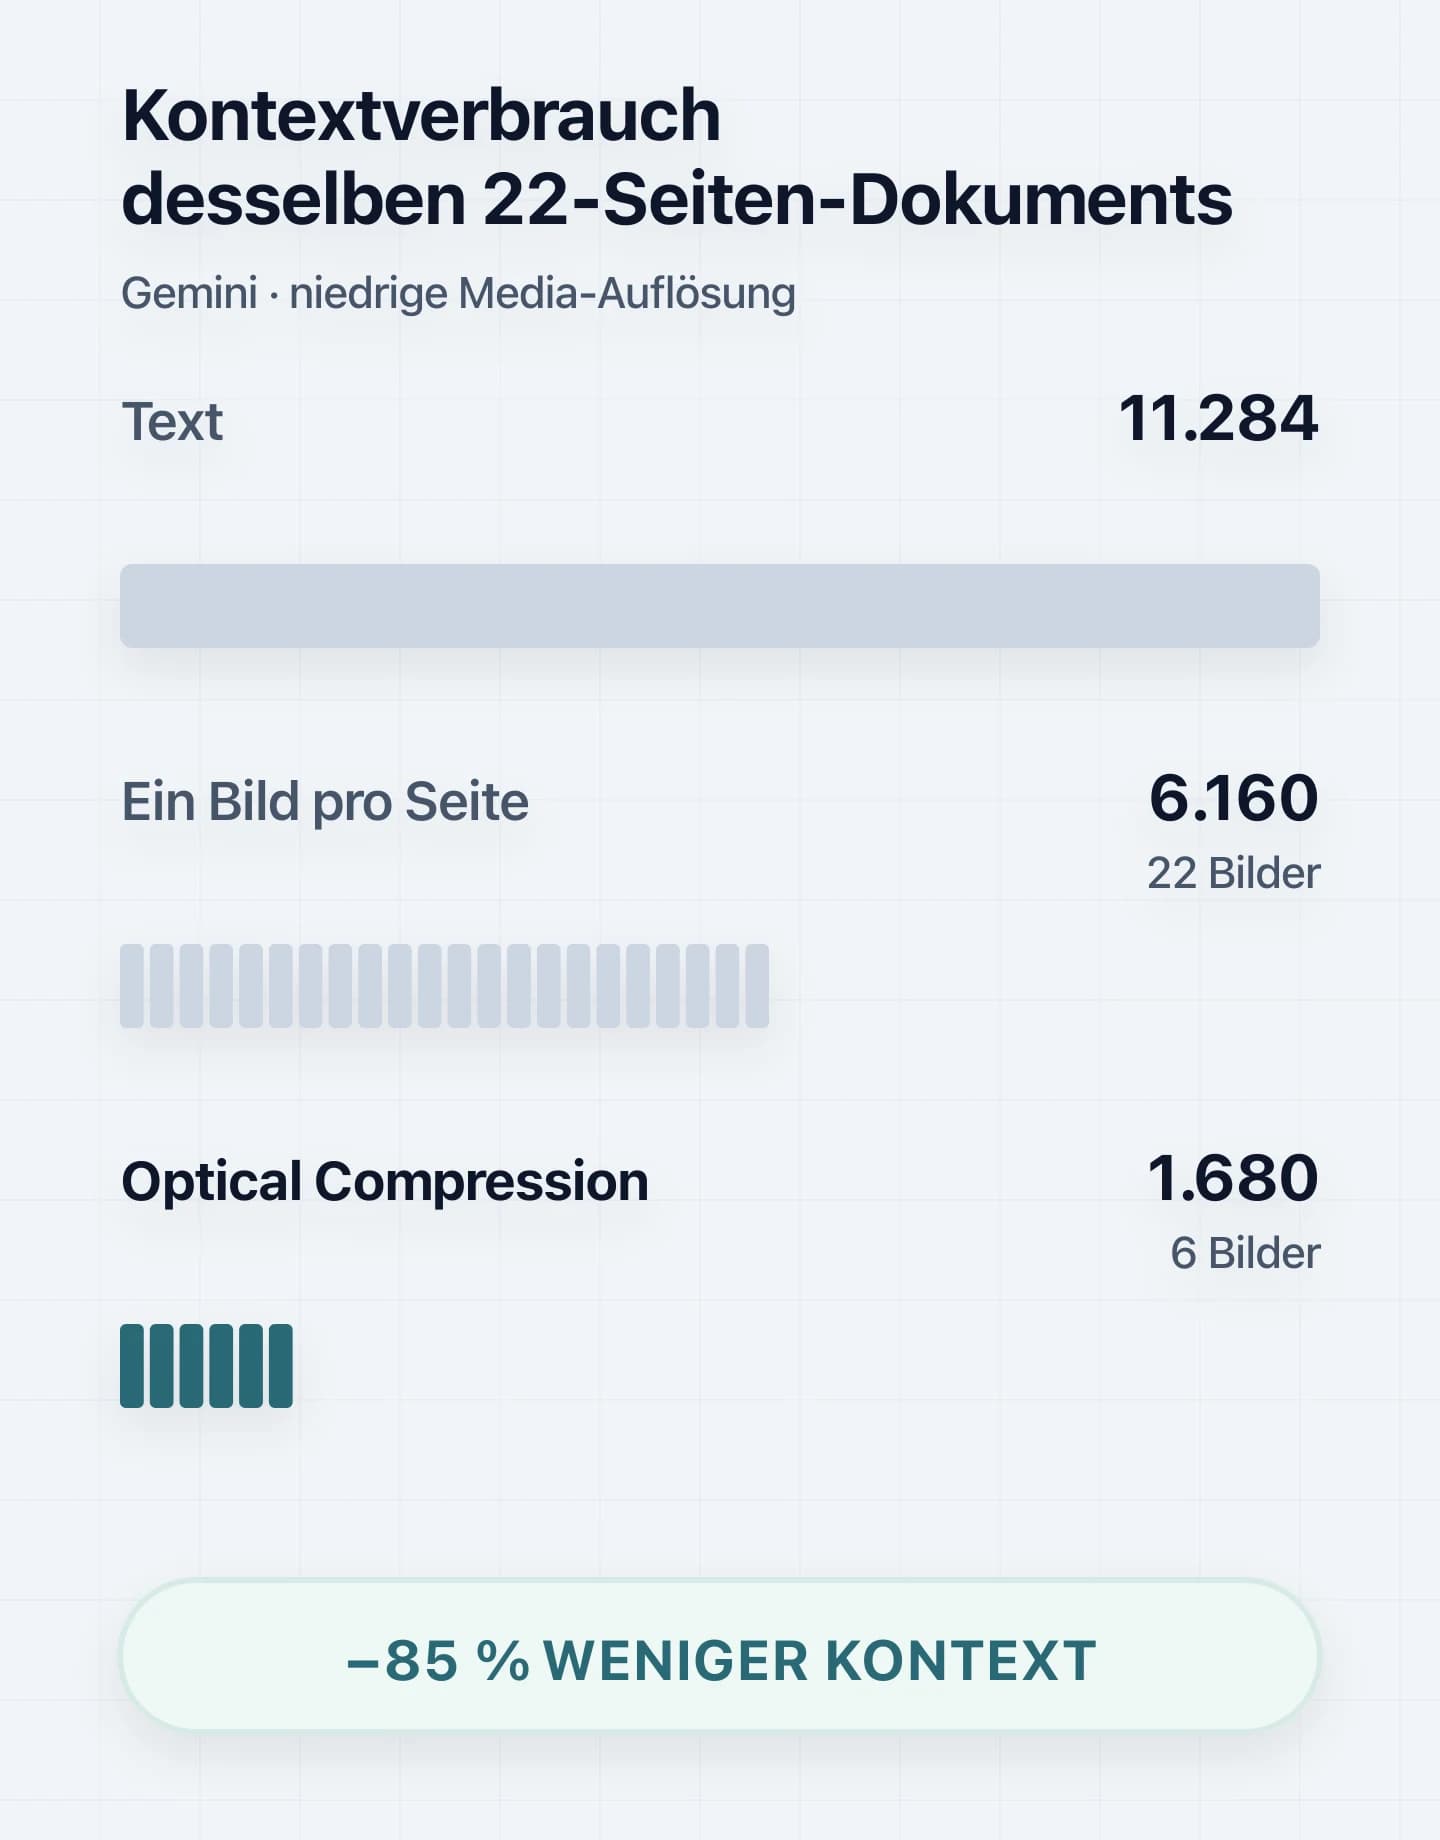
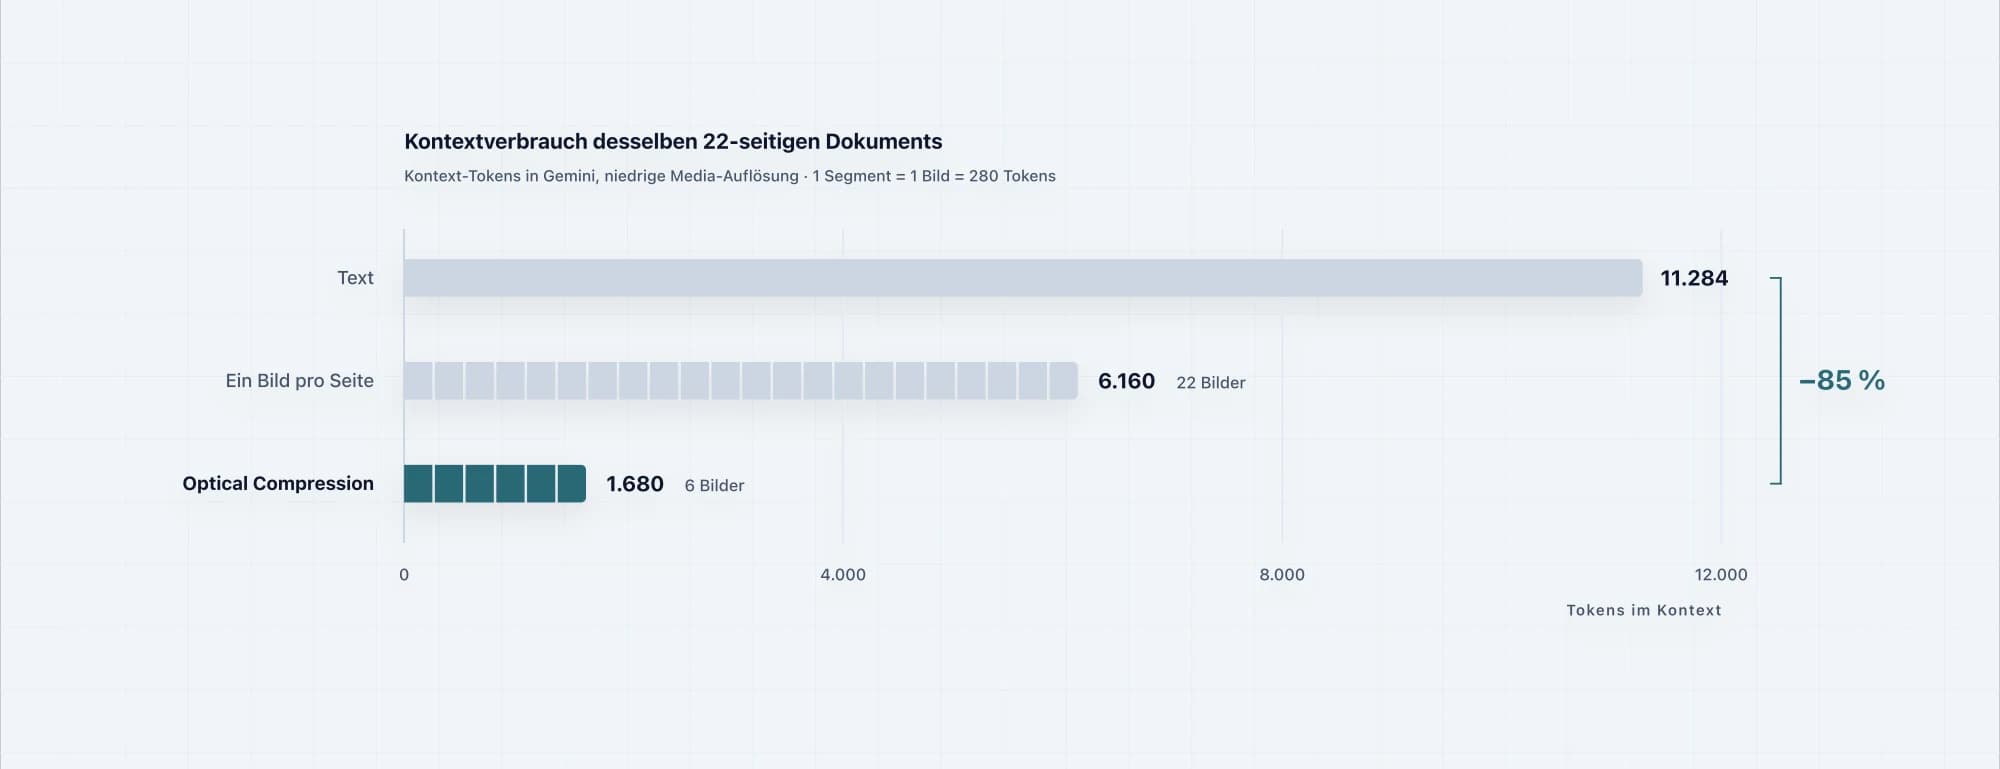
Der Rest dieses Beitrags erklärt, warum das funktioniert, wie die Pipeline aufgebaut ist und wo die Grenzen liegen.
Warum Text als Bild überhaupt günstiger sein kann
Der Ausgangspunkt ist das Paper DeepSeek-OCR: Contexts Optical Compression (Wei, Sun, Li, 2025). Die Autoren zeigen, dass ein Vision-Encoder Text deutlich kompakter kodieren kann als ein Text-Tokenizer: Solange die Zahl der Text-Tokens innerhalb des Zehnfachen der Vision-Tokens bleibt, erreicht das Modell beim Zurücklesen eine OCR-Genauigkeit von rund 97 %. Bei einer Kompression von 20× sind es noch etwa 60 %.
Daraus folgt eine einfache Regel: Eine Seite lohnt sich als Bild, wenn ihr Text mehr Tokens kostet als das Bild selbst. Und sie lohnt sich umso mehr, je dichter das Bild gepackt ist – bis zu der Grenze, an der das Modell den Text nicht mehr zuverlässig lesen kann.
Die Pipeline
Das veröffentlichte Paket optical-context-mcp setzt das als MCP-Server um, den jeder MCP-fähige Client einbinden kann. Der Ablauf:
- OCR und Seitenbilder. Das PDF läuft durch Mistral OCR, das Layout wird pro Seite erfasst und gerendert.
- Sizing-Modell. Wie dicht sich Seiten packen lassen, hängt vom Dokument ab: eine Tabelle mit 6-Punkt-Schrift verträgt weniger als ein Fließtext. Deshalb entscheidet kein fester Schwellwert, sondern ein MobileNetV3, das ich auf 9.076 geprüften Bildern trainiert habe. Auf fünf unabhängigen Dokument-Holdouts liegt die Accuracy zwischen 0,700 und 0,923.
- Packen. Die Seiten werden zu Bildpaketen zusammengelegt – im Testdokument werden aus 22 Seiten sechs Bilder.
- Übergabe. Die Bildpakete gehen als Ganzes an das Vision-LLM; der Server bietet dafür drei Tools an.
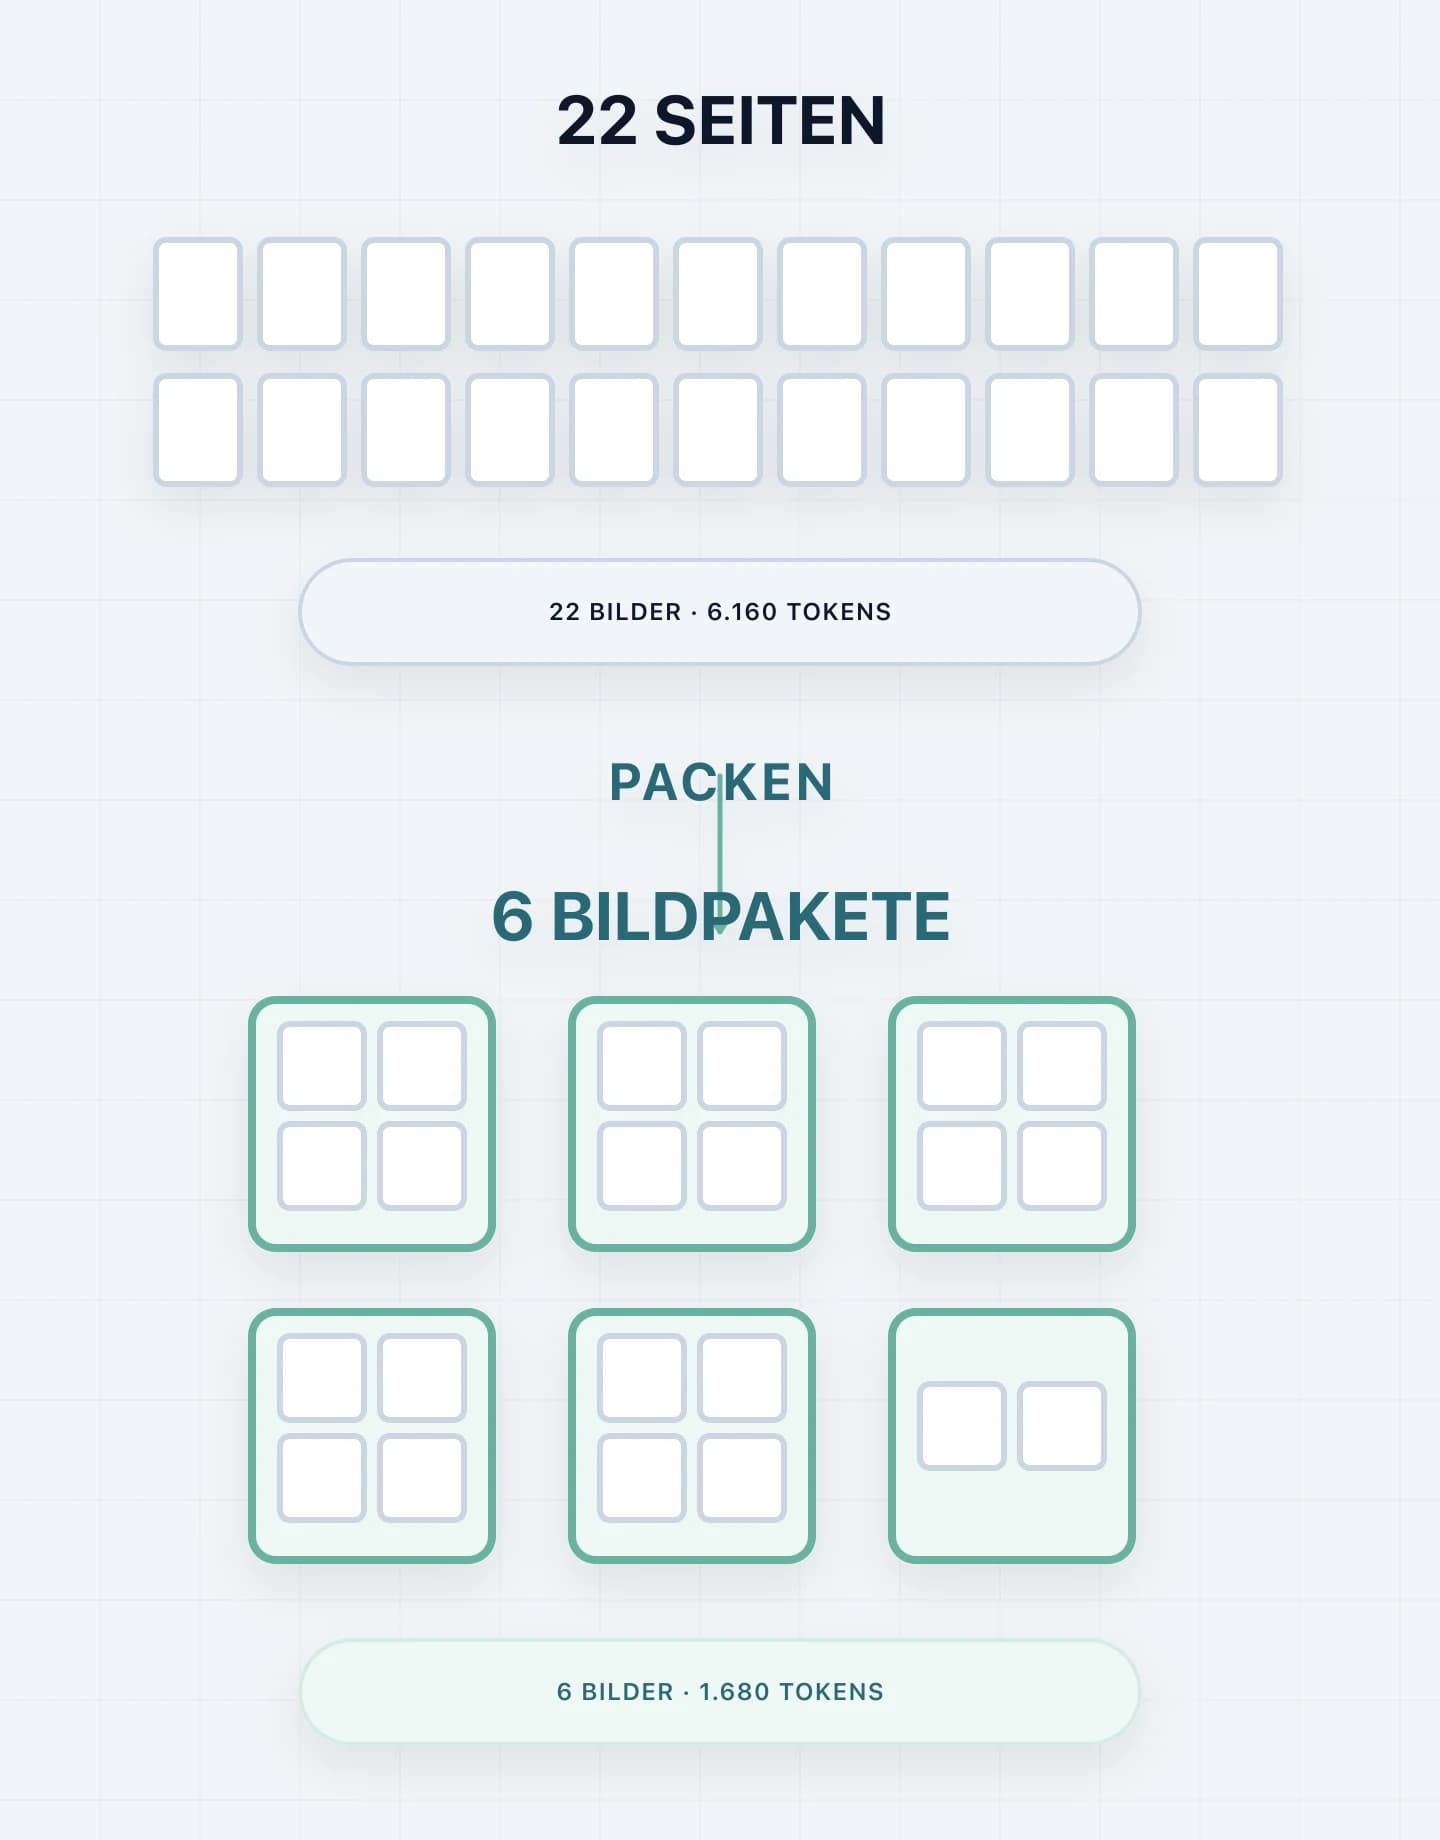
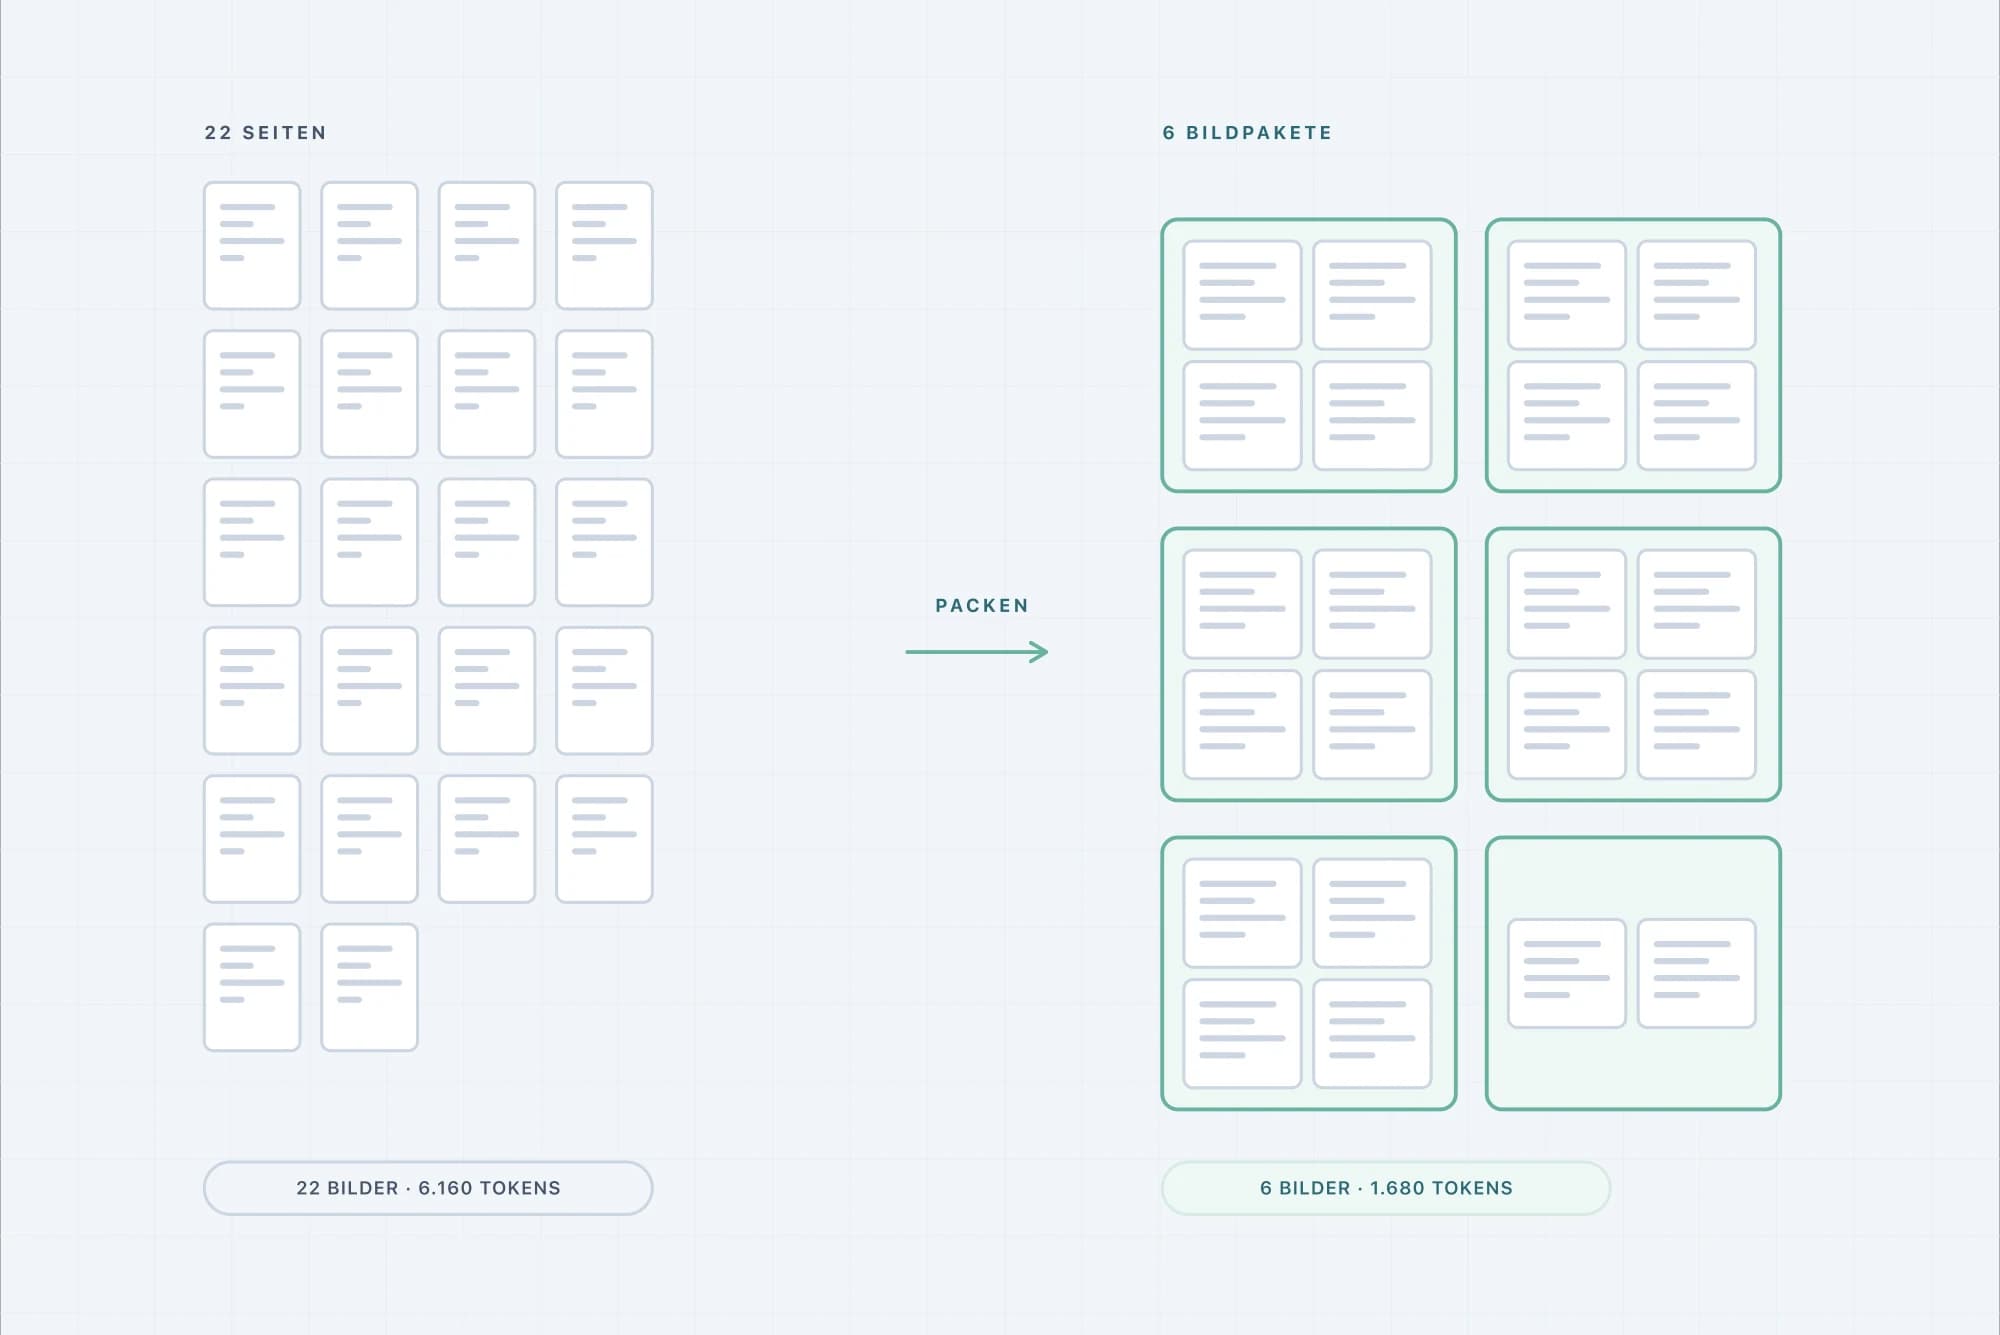
Das Paket wird über GitHub Actions mit Trusted Publishing nach PyPI ausgeliefert, bislang in fünf Releases.
Was die Messung ergibt
Als Testdokument habe ich das DeepSeek-OCR-Paper selbst genommen: 22 Seiten, eine Mischung aus Fließtext, Formeln, Abbildungen und einer langen Literaturliste. Vision-Tokens habe ich mit Gemini über OpenRouter in der niedrigen Media-Auflösung gezählt, in der jedes Bild 280 Tokens kostet.
| Variante | Bilder | Tokens im Kontext | Anteil |
|---|---|---|---|
| Text-Tokens (Original) | – | 11.284 | 100 % |
| Ein Bild pro Seite (Baseline) | 22 | 6.160 | 55 % |
| Optical Compression | 6 | 1.680 | 15 % |
Gegenüber dem Text sind das 6,72× weniger Tokens, gegenüber der naiven Bild-pro-Seite-Variante noch einmal ein Faktor von gut 3,5. Anders gesagt: bis zu 85 % weniger Kontext für dasselbe Dokument.
Nicht jede Seite lohnt sich
Interessanter als der Durchschnitt ist die Verteilung. Weil ein Bild fix 280 Tokens kostet, liegt der Break-even bei 280 Text-Tokens pro Seite. Im Testdokument lagen 20 von 22 Seiten darüber; die beiden Ausnahmen waren zwei fast leere Seiten am Ende des Dokuments mit 85 beziehungsweise 243 Text-Tokens. Für die dichteste Seite – 2.148 Text-Tokens – sparte das Bild 1.868 Tokens. Als Faustregel hat sich ergeben: Ab etwa 420 Text-Tokens pro Seite ist der Gewinn stabil über 1,5×.
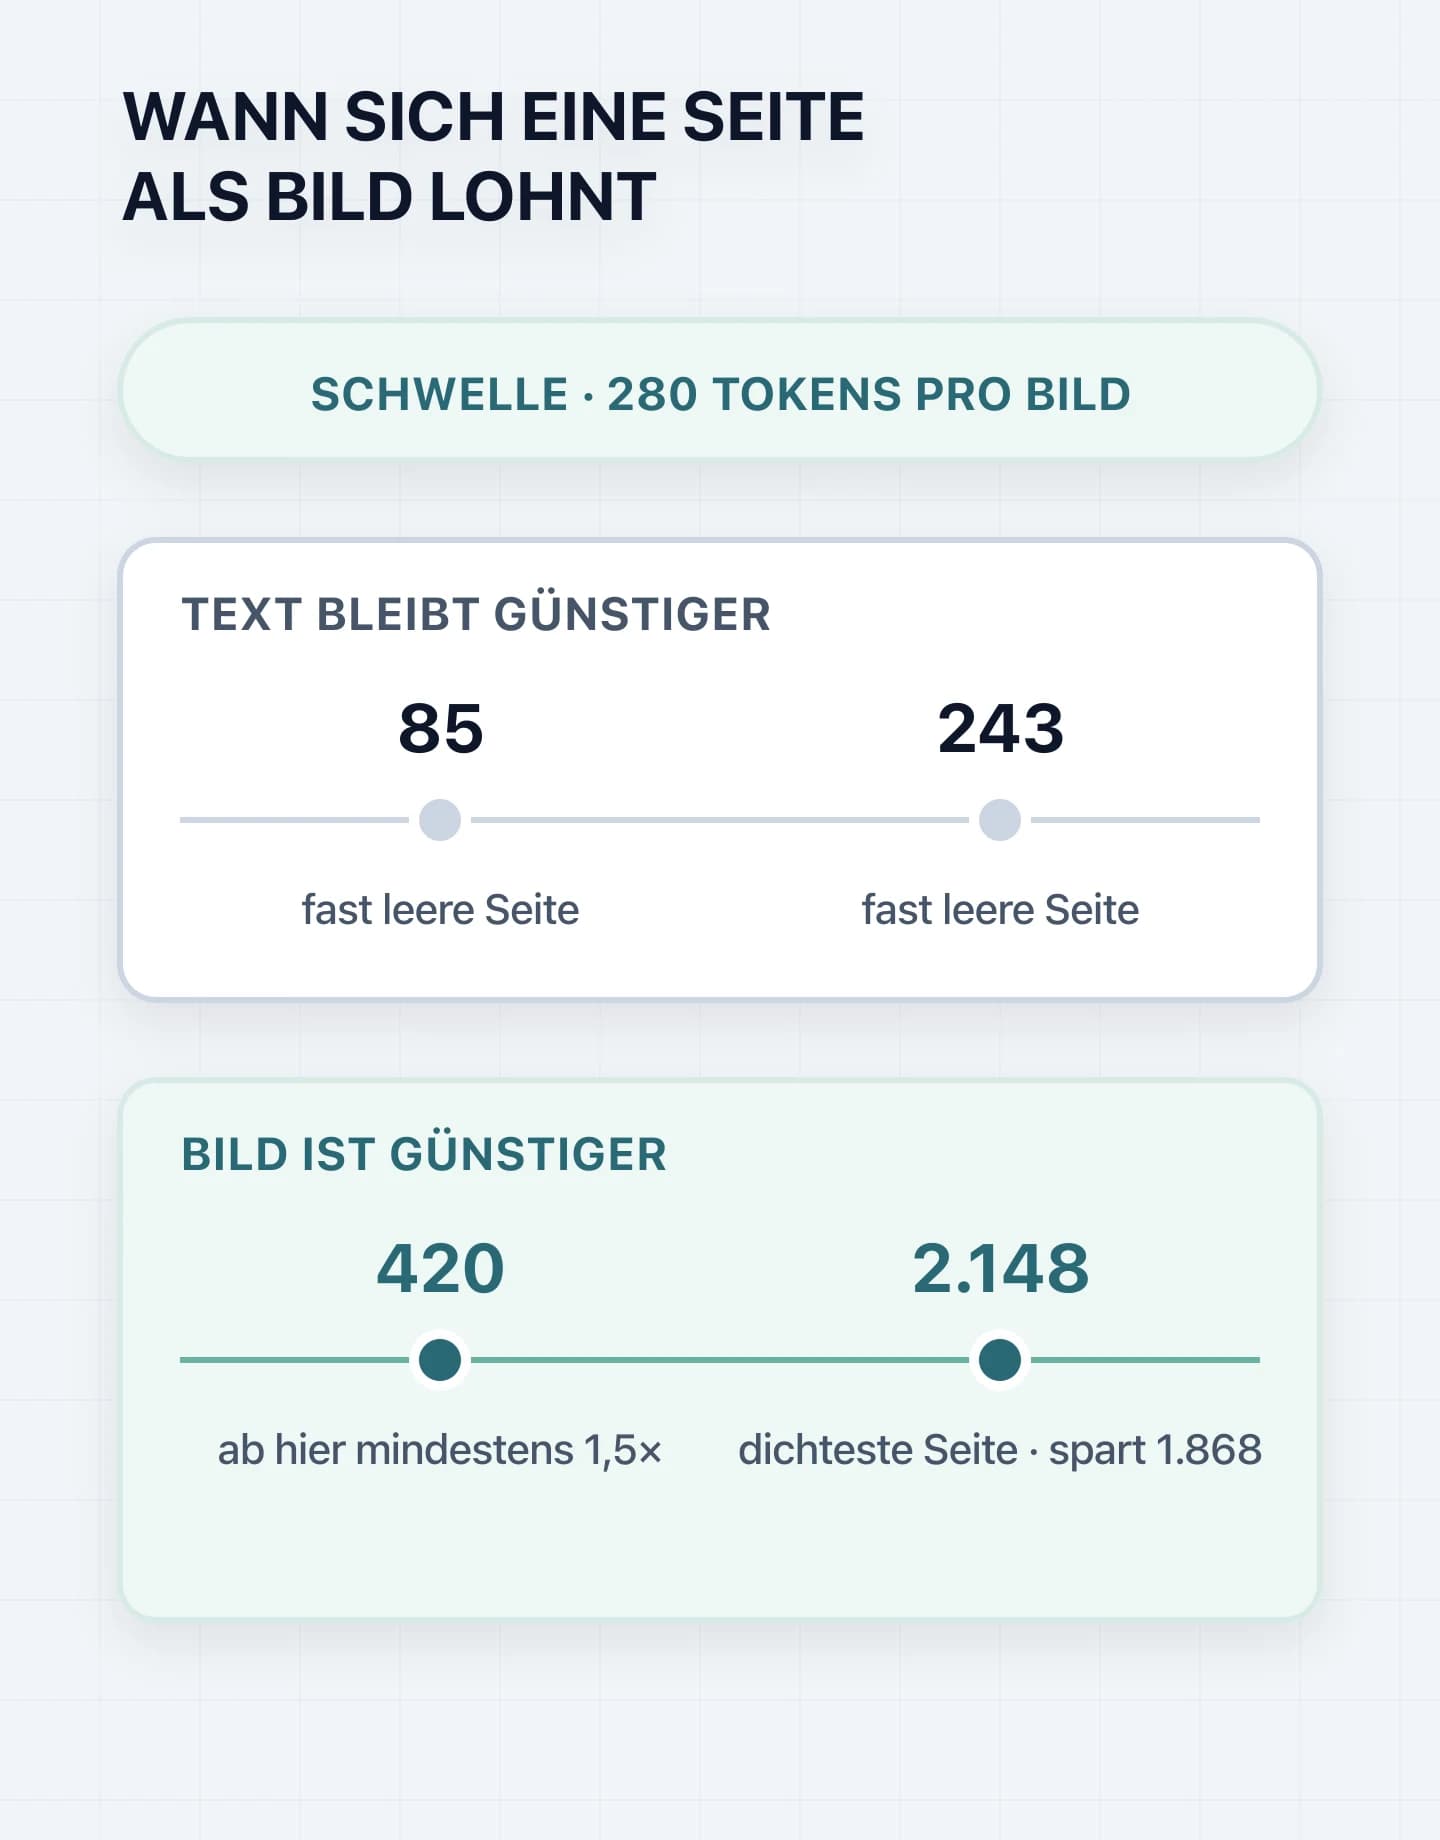
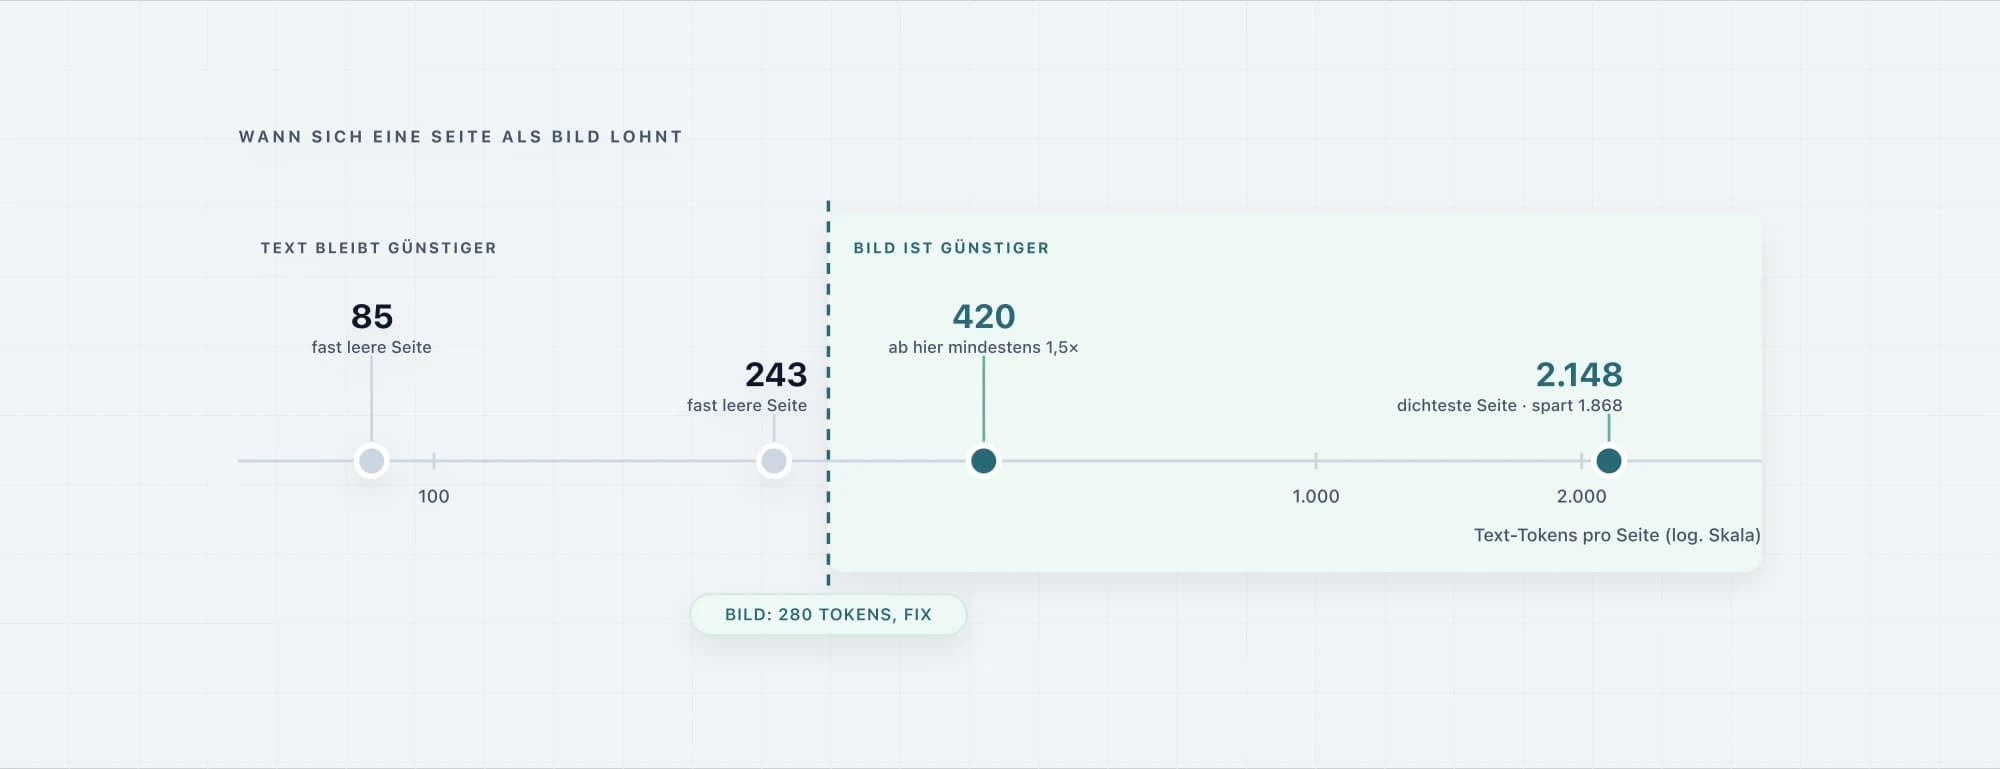
Der Server rechnet das deshalb pro Seite und packt nur, was sich lohnt – fast leere Seiten bleiben Text.
Wo die Grenzen liegen
Drei Dinge sollte man wissen, bevor man das produktiv einsetzt:
- Die Genauigkeit sinkt mit der Dichte. Die Werte aus dem DeepSeek-Paper gehen von 98,5 % bei 6–7-facher Kompression auf 89,8 % bei 11–12-facher zurück. Das Sizing-Modell existiert genau deshalb – es soll die Dichte wählen, die das Dokument verträgt, nicht die maximale.
- Die 85 % sind eine Kontextreduktion, kein Qualitäts-Benchmark. Gemessen sind Tokens, nicht die Antwortqualität des Modells auf Fragen zum Dokument. Das ist der nächste Schritt.
- Ein Dokument ist ein Datenpunkt. Die Zahlen gelten für dieses Paper mit diesem Modell in dieser Auflösung. Für Scans mit schlechter Qualität oder sehr kleine Schrift muss man neu messen.
Ausprobieren
pip install optical-context-mcp
Der Quellcode des Servers liegt auf GitHub, die Messreihen und Diagramme im Forschungs-Repository. Die Case Study zum Projekt fasst Architektur und Ergebnisse auf einer Seite zusammen.
Zur Case StudyOptical Context MCP