CASE STUDY
Academic DeepSearch
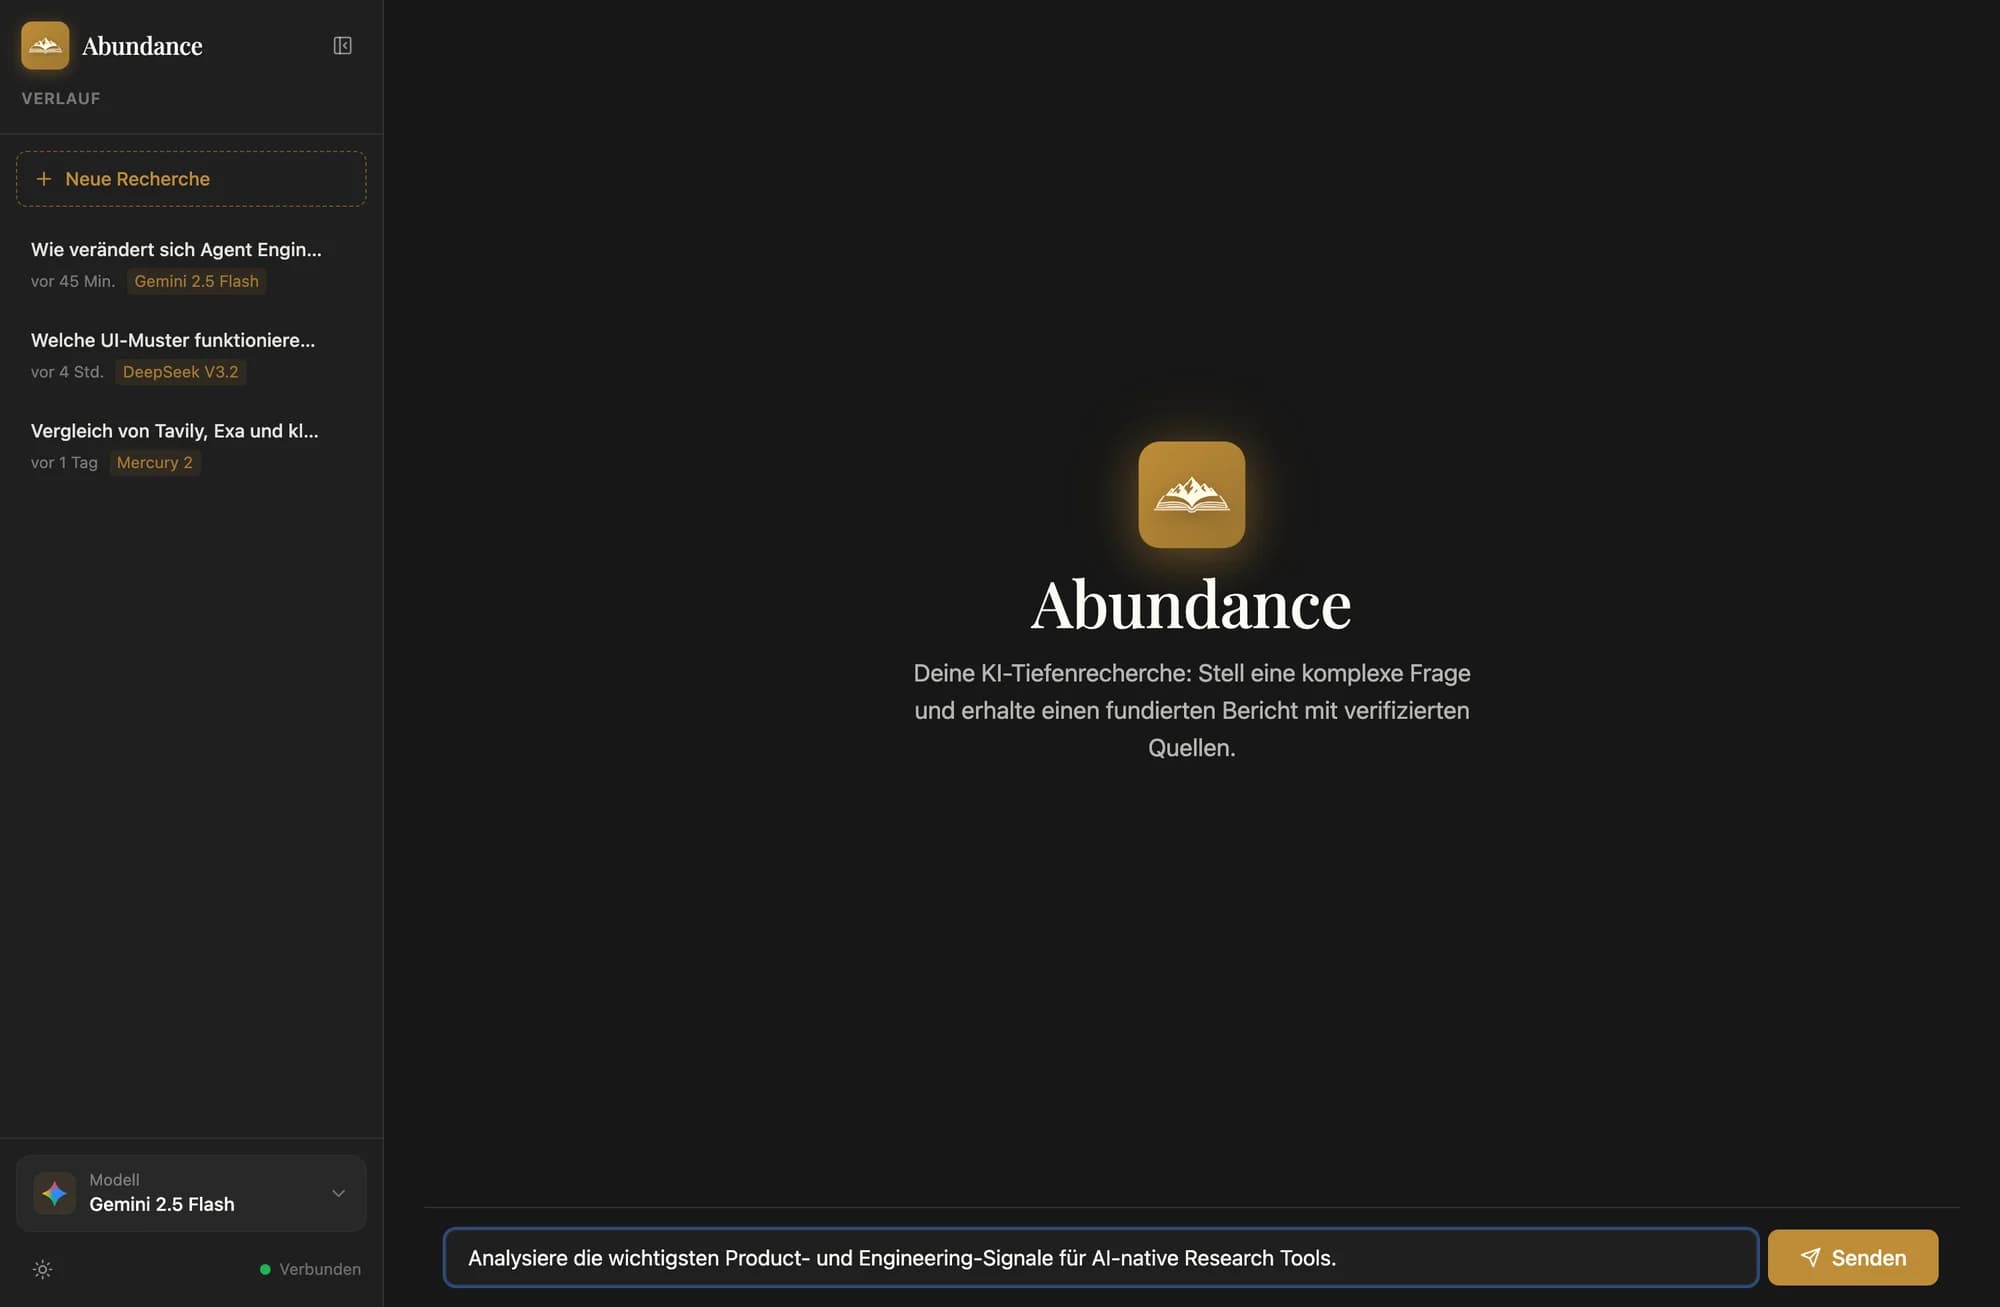
Abundance: eine Deep-Research-Anwendung, die aus einer komplexen Frage einen belegten Bericht macht – mit Gegenbelegen, kalibrierter Konfidenz und Zitaten, die nur auf zugelassene Quellen zeigen dürfen.
- Rolle
- Konzeption, Architektur und Entwicklung
- Status
- Open Source (MIT) auf GitHub, Release v1.0.0
AUSGANGSLAGE
Problem
Deep-Research-Tools klingen überzeugend, aber die Kette von der Behauptung zur Quelle reißt schnell: Das Modell entscheidet selbst, welche Werkzeuge laufen, zitiert Seiten, die nie geprüft wurden, und liefert eine Konfidenz, die niemand nachrechnen kann. Für akademische Fragen ist genau das unbrauchbar – dort muss jeder Satz auf einen Beleg zurückführbar sein, und der Gegenbeleg gehört mit in den Bericht.
SO FUNKTIONIERT ES
Lösung & Architektur
Recherche
Der Graph entscheidet, nicht das Modell
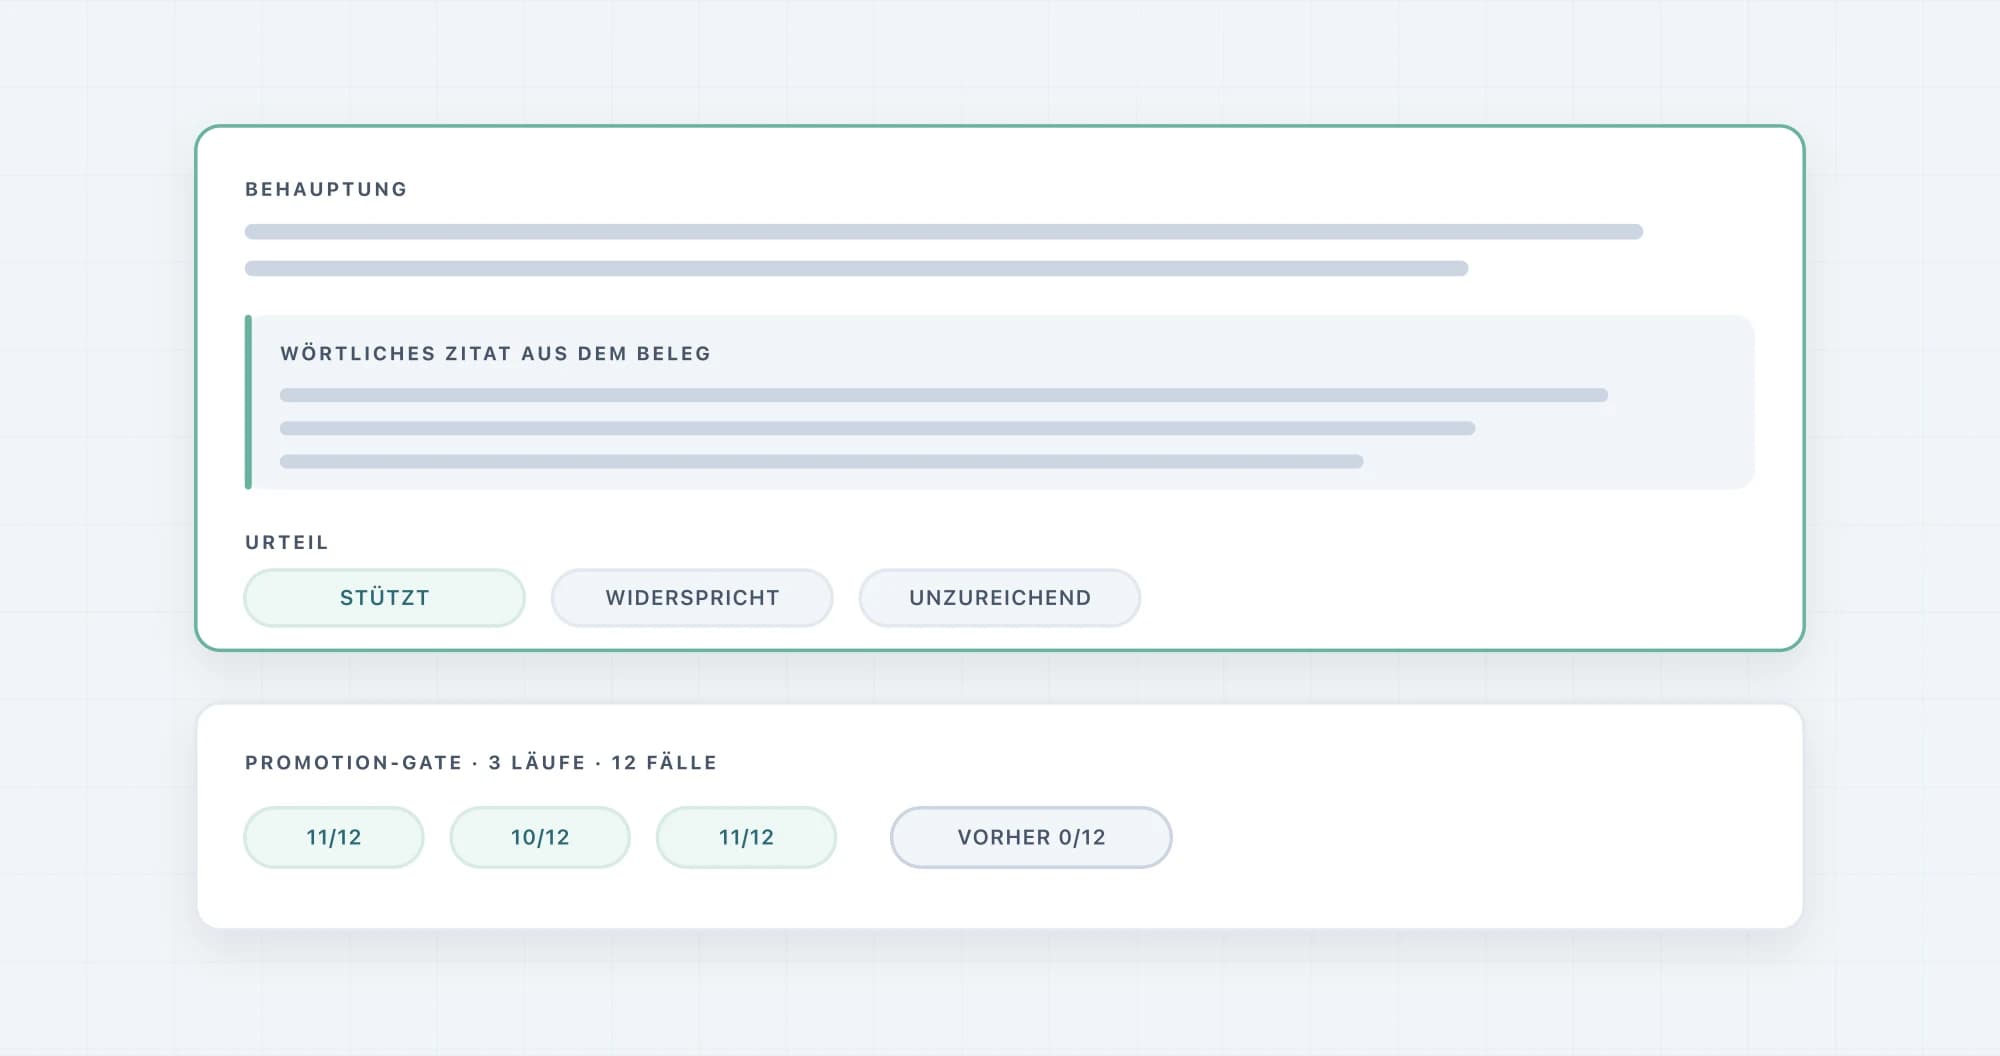
Die Recherche läuft als deterministischer LangGraph-Workflow mit acht Stufen. Das Modell plant falsifizierbare Belegfragen und synthetisiert am Ende, aber welche Fähigkeit wann läuft, legt der Graph fest. Belege werden parallel und nur lesend gesammelt; Quellenzulassung, Deduplizierung und Zitatbindung sind Code, keine Prompts. Drei Modi setzen harte Budgets von 9, 30 oder 60 Belegen pro Lauf.
- 8 Stufen, vom Scoping bis zur Veröffentlichung
- Quick, Balanced, Thorough: maximal 9, 30 oder 60 Belege
- Abgerufener Text gilt als nicht vertrauenswürdige Daten
Verifikation
Jede Behauptung muss auf ihren Beleg zeigen
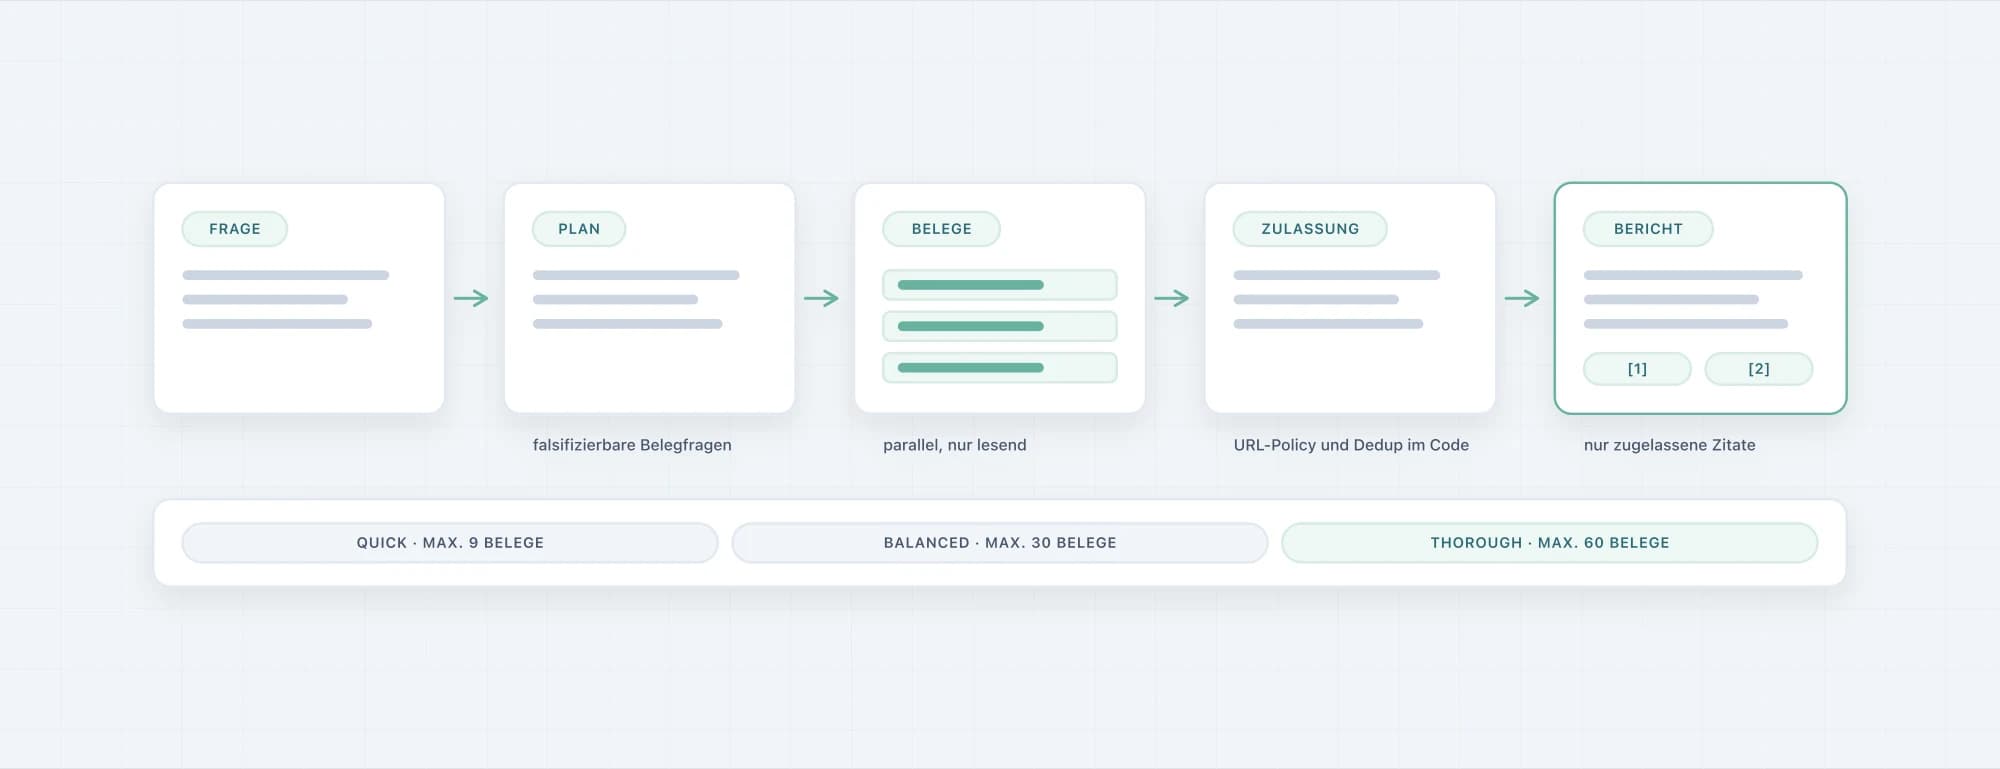
Zitate im Bericht dürfen nur auf zugelassene Belege verweisen – das erzwingt der Code. Zusätzlich prüft ein festgepinntes DeepSeek-V4-Flash-Profil im Schattenmodus, ob der gebundene Beleg eine Behauptung stützt, ihr widerspricht oder nicht ausreicht. Freigeschaltet wird ein solches Modell nur über ein reproduzierbares Gate: drei Läufe auf einem versionierten Datensatz mit zwölf Fällen, auf dem der alte Zitat-Check 0 von 12 bestand.
- Verdicts stützt, widerspricht, unzureichend – jeweils mit wörtlichem Zitat
- 3 Läufe: 11/12, 10/12 und 11/12 bestanden
- Schattenmodus: misst den Bericht, kann ihn aber nicht umschreiben
ARCHITEKTUR
Der Weg durch das System
Frage
komplexe Fragestellung
Plan
falsifizierbare Belegfragen
Belege
parallele Suche, nur lesend (Tavily)
Zulassung
URL-Policy und Dedup im Code
Synthese
strukturierte Claims mit Beleg-IDs
Verifikation & Bericht
Zitatbindung, deterministisches Rendering
Streaming
SSE-Events mit stabilem Vertrag; ein Abbruch läuft vom Browser bis in den Graph
Persistenz
PostgreSQL für Runs, Berichte, Metriken und LangGraph-Checkpoints
Qualitätssicherung: CI mit Tests, mypy, ruff und pip-audit; Eval-Harness mit 30 Referenzfällen und einem Promotion-Gate über 3 Läufe für die Claim-Verifikation
Ergebnisse
- deterministische Stufen im LangGraph-Workflow
- 8deterministische Stufen im LangGraph-Workflow
- Belege je Recherche, hart budgetiert nach Modus
- bis zu 60Belege je Recherche, hart budgetiert nach Modus
- mittlere Pass-Rate der Claim-Verifikation über 3 Läufe (12 Fälle)
- 89 %mittlere Pass-Rate der Claim-Verifikation über 3 Läufe (12 Fälle)
- Pass-Rate des vorherigen Zitat-Checks am selben Datensatz
- 0/12Pass-Rate des vorherigen Zitat-Checks am selben Datensatz
NACHWEIS & EINORDNUNG
Was belegt ist – und wo die Aussage endet
Die vier Felder trennen meinen Beitrag, den Projektkontext, die Messgrundlage und die Grenzen der Ergebnisse.
- Mein Anteil
- Konzeption, Architektur und Entwicklung des achtstufigen LangGraph-Workflows, der Quellenzulassung, Zitatbindung, Persistenz, Streaming-Schnittstelle und des Eval-Gates.
- Team & Kontext
- Das Projekt ist als MIT-lizenziertes Release v1.0.0 öffentlich auf GitHub. Die Case Study quantifiziert keine weiteren Teambeiträge und leitet aus dem Open-Source-Status keine alleinige Urheberschaft ab.
- Messgrundlage
- Das Promotion-Gate nutzt zwölf versionierte Claim-Verifikationsfälle und drei Läufe mit 11/12, 10/12 und 11/12 bestandenen Fällen, im Mittel 89 %. Der vorherige Zitat-Check erreichte auf demselben Datensatz 0/12; das gesamte Eval-Harness enthält 30 Referenzfälle.
- Grenzen
- Die 89 % beziehen sich auf zwölf Fälle und ein festgepinntes Modellprofil, nicht auf beliebige Forschungsfragen oder Modelle. Die Verifikation läuft im Schattenmodus: Sie misst den Bericht, darf ihn aber nicht umschreiben.
GEBAUT MIT
Tech-Stack
- Python
- FastAPI
- LangGraph
- LangChain
- OpenRouter
- Tavily
- PostgreSQL
- Next.js
- React
- Upstash Redis
- Docker
- GitHub Actions
Links
Vertiefung
- NotizLangGraph Deep Research: Zitate verifizieren statt nur verlinkenWie Abundance Behauptungen, zugelassene Belege und wörtliche Zitate im Code bindet – und warum die semantische Prüfung bewusst nur im Schattenmodus misst.
- NotizLLM-Evals mit kleinem Referenzdatensatz: Was 12 Fälle leistenWas ein versionierter Eval-Satz mit zwölf Fällen zuverlässig absichert, wie drei Läufe mit 11/12, 10/12 und 11/12 bewertet werden – und wo die Aussage endet.
Passt das zu dem, was du vorhast?
Ich baue Systeme, die produktiv laufen sollen statt nur zu demonstrieren. Wenn das zu deinem Vorhaben passt, schreib mir.
Alle Case Studies